찾아보고 싶은 뉴스가 있다면, 검색
검색
최근검색어
  • DLSS 5
    2026-10-18
    검색기록 지우기
저장된 검색어가 없습니다.
검색어 저장 기능이 꺼져 있습니다.
검색어 저장 끄기
전체삭제
총 16 건
  • 엔비디아, AI 슈퍼컴퓨터 성능 담은 노트북 출시…MS·델 등 6개사 참여

    엔비디아, AI 슈퍼컴퓨터 성능 담은 노트북 출시…MS·델 등 6개사 참여

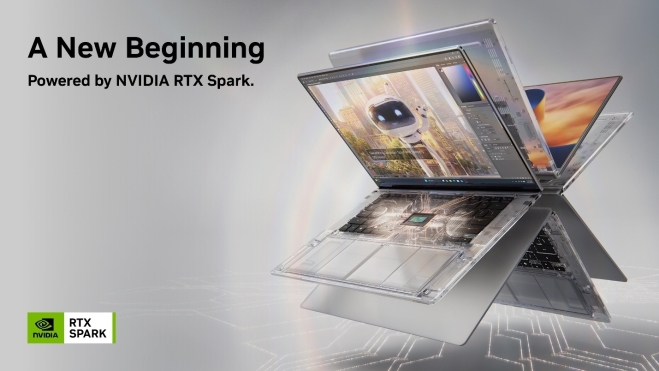
    엔비디아가 대형 인공지능(AI) 모델을 외부 서버에 연결하지 않고도 구동할 수 있는 고성능 노트북 ‘RTX 스파크’를 출시했다. 데이터센터에서 주로 활용하던 AI 연산 기술을 개인용 PC로 확장해 콘텐츠 제작부터 AI 프로그램 개발, 게임까지 하나의 기기에서 처리할 수 있도록 했다. 엔비디아는 16일부터 마이크로소프트(MS), 델, HP, 레노버, 에이수스, MSI 등 6개 제조사를 통해 RTX 스파크 노트북을 판매한다고 밝혔다. 가격은 2599달러부터 시작하며 국가와 제품 구성에 따라 달라진다. RTX 스파크에는 엔비디아의 블랙웰 그래픽처리장치(GPU)와 그레이스 중앙처리장치(CPU)를 결합한 슈퍼칩이 탑재됐다. 최대 128기가바이트(GB)의 통합 메모리와 초당 1000조번의 연산에 해당하는 1페타플롭의 AI 연산 성능을 제공한다. 다만 이는 데이터를 4비트 단위로 처리하는 FP4 정밀도 기준이다. CPU 설계에는 대만 반도체 기업 미디어텍이 참여했다. 가장 큰 특징은 대형언어모델(LLM)과 AI 에이전트를 노트북 자체에서 실행할 수 있다는 점이다. 외부 클라우드 서버에 데이터를 보내지 않고도 문서 처리나 코드 작성 등 AI 작업을 수행할 수 있다. 개발자는 별도의 서버를 구축하지 않고 노트북에서 AI 모델을 시험하고 프로그램을 개발할 수 있다. 콘텐츠 제작과 게임 성능도 강화했다. 엔비디아에 따르면 전원에 연결하지 않은 상태에서도 8K 영상 편집과 최대 90GB 규모의 3차원(3D) 장면 렌더링이 가능하다. 어도비는 포토샵과 프리미어의 AI 편집 기능에 엔비디아의 가속 기술을 적용했다. 게임에서는 AI를 활용해 화질과 프레임 속도를 높이는 ‘DLSS 5’ 기술을 지원한다. 엔비디아는 MS와 협력해 윈도 운영체제에서도 AI 개발 도구를 활용할 수 있도록 했다. 기존에 리눅스 환경을 중심으로 사용되던 AI 개발 기술을 윈도 노트북으로 확대하는 것으로, 개발자뿐 아니라 일반 이용자도 AI 에이전트를 보다 쉽게 활용할 수 있도록 한다는 구상이다. 엔비디아는 이날 오후 서울 코엑스에서도 RTX 스파크 출시 기념 체험 행사를 열었다. 서울을 비롯해 미국 샌프란시스코, 독일 베를린, 대만 타이베이 등 세계 6개 도시에서 신제품을 선보였다. 젠슨 황 엔비디아 최고경영자(CEO)는 “RTX 스파크는 슈퍼컴퓨터와 게이밍 PC, 워크스테이션의 성능을 하나의 슬림하고 전력 효율이 뛰어난 기기에 담았다”며 “누구나 어디서든 개발하고 창작하며 게임을 즐길 수 있도록 하겠다”고 말했다.
  • ‘RTX 스파크 노트북’ 공개…맥북 프로 대항마 될까 [고든 정의 TECH+]

    ‘RTX 스파크 노트북’ 공개…맥북 프로 대항마 될까 [고든 정의 TECH+]

    엔비디아의 ‘RTX 스파크’를 탑재한 노트북들이 하나씩 공개되고 있습니다. ARM 윈도우에 상당한 공을 들여온 마이크로소프트 역시 RTX 스파크를 탑재한 서피스 랩톱 울트라를 공개했는데, 24GB 통합 메모리, 512GB SSD, 최대 밝기 2,000니트의 15인치 미니 LED HDR 터치스크린을 포함한 사양으로는 다소 경쟁력 있는 2599달러의 가격을 책정했습니다. 다만 128GB 메모리에 20코어 CPU, 6144코어 GPU, 1TB SSD를 포함한 최고 사양의 SoC를 선택하면 가격은 5899달러로 껑충 뛰게 됩니다. 엔비디아의 RTX 스파크는 DGX 스파크 AI 미니 PC에 사용된 GB10 슈퍼칩의 노트북 버전인 N1X와 N1을 사용합니다. N1X는 20코어 Arm CPU와 6,144개의 CUDA 코어를 지니고 있으며 N1은 이보다 코어 수를 줄인 컷칩으로 보급형이라고 할 수 있습니다. 메모리는 256bit LPDDR5X를 사용하는데, 노트북 버전의 정확한 속도는 알려져 있지 않으나 과거 GB10을 보면 300GB/s 이내로 추정됩니다. 서피스 랩톱 울트라 같은 RTX 스파크 노트북의 가장 직접적인 경쟁 상대는 바로 애플 맥북 프로입니다. 가격을 감안하면 일반적인 업무용 노트북으로 사용하기에는 너무 비싸고 로컬 대형 언어 모델(LLM) 구동이나 AI 이미지·영상 생성, 3D 작업 등을 위한 모바일 워크스테이션에 가깝습니다. 맥북 프로는 이 분야에서 나름 자신의 입지를 구축한 상태입니다. 기본적으로 맥은 이미지 및 영상 편집 작업에서 널리 사용되고 있으며 여기에 M5 프로와 M5 맥스의 경우 각각 307GB/s와 614GB/s의 메모리 대역폭을 제공해 로컬 LLM 구동 시 토큰 속도에 유리합니다. 특히 애플의 통합 메모리 구조 덕분에 전체 메모리의 상당 부분을 AI 모델에 할당할 수 있어 보통 8~16GB 정도인 독립 그래픽 카드 탑재 노트북보다 더 큰 모델을 올리고 원활하게 돌릴 수 있습니다. RTX 스파크는 여기에 도전하는 윈도우 진영의 새로운 카드입니다. 마이크로소프트 입장에서 보면 기존 ARM 윈도우 노트북에 사용된 스냅드래곤 프로세서는 전력 효율과 배터리 사용 시간에서는 장점이 있지만, 고성능 그래픽과 일부 전문 AI 작업에서는 한계가 있었습니다. 게임 호환성 역시 ARM 윈도우의 약점 중 하나였습니다. RTX 스파크는 엔비디아의 GPU 기술과 소프트웨어 생태계를 결합해 이런 약점을 보완했습니다. 블랙웰 GPU 덕분에 레이 트레이싱과 DLSS, G-SYNC 등 엔비디아의 최신 그래픽 기술도 활용할 수 있고, ARM용으로 제작되지 않은 x86 기반 윈도우 프로그램과 게임도 프리즘 에뮬레이션을 통해 실행할 수 있습니다. 실제로 마이크로소프트는 N1X 칩셋 기반의 노트북으로 007 퍼스트 라이트, 포르자 호라이즌 6 같은 게임을 매끄럽게 구동하는 모습을 공개하기도 했습니다. 다만 실제 구동 가능한 게임의 범위와 성능은 제품이 출시된 이후 정확히 확인할 수 있을 것으로 보입니다. 로컬 AI 구동 시에는 본래 이 목적을 위해 개발된 RTX 스파크의 성능이 더 빛을 발합니다. 최대 128GB의 통합 메모리 가운데 상당 부분을 로컬 AI 모델을 위해 할당할 수 있어 매우 큰 모델을 돌릴 수 있고 CUDA 아키텍처의 힘을 통해 속도를 높일 수 있습니다. 따라서 과거 스냅드래곤 SoC에서는 어려웠던 모바일 워크스테이션급 Arm 윈도우 노트북이 이제야 가능하게 된 것입니다. 다만 넘어야 할 산도 많습니다. 게임 성능과 가격 대비 효율에서는 RTX 50 시리즈 그래픽카드를 탑재한 일반 게이밍 노트북이 여전히 매력적일 수 있습니다. 전문 영상 작업에서는 맥북 프로가 오랜 기간 쌓아온 소프트웨어 지원과 작업 환경이라는 강점을 갖고 있습니다. RTX 스파크 노트북이 두 제품군 사이에서 확실한 입지를 확보하려면 대형 AI 모델을 실행할 수 있다는 장점뿐 아니라 실제 처리 속도와 가격 경쟁력도 입증해야 합니다. 솔직히 초기 가격표만 보면 RTX 스파크의 경쟁력이 압도적으로 높다고 평가하기는 어렵습니다. 여기에 메모리 가격 폭등으로 인한 노트북 가격 상승과 이로 인한 수요 감소는 이제 막 시장에 진입하는 RTX 스파크 노트북에 악재로 작용하고 있습니다. 과연 RTX 스파크 노트북이 계속해서 후속 제품을 개발할 수 있을 만큼 시장 반응을 이끌어 낼지 앞으로 성과가 주목됩니다.
  • 엔비디아 ‘RTX 스파크’, 윈도우 ARM으로 고성능 PC 재창조할까 [고든 정의 TECH+]

    엔비디아 ‘RTX 스파크’, 윈도우 ARM으로 고성능 PC 재창조할까 [고든 정의 TECH+]

    엔비디아가 AI 미니 슈퍼컴퓨터 ‘DGX 스파크’의 모바일 버전인 ‘RTX 스파크(RTX Spark)’를 공개했습니다. RTX 스파크는 DGX 스파크에 탑재된 GB10의 모바일 변형 버전인 N1X를 탑재하고 있으며, 최대 20코어의 Arm 기반 CPU와 6,144개의 CUDA 코어를 갖춘 블랙웰 아키텍처 GPU로 구성되어 있습니다. 엔비디아는 모든 RTX 스파크가 동일한 칩을 사용하는지 아니면 일부 기능을 줄이고 가격을 낮춘 컷 칩(cut-chip)이 존재하는지에 대해서는 이날 공개 행사에서 구체적으로 밝히지 않았습니다. 다만 RTX 스파크가 최대 128GB의 LPDDR5x와 1페타플롭스의 연산 능력으로 노트북에서도 고사양 게임을 원활하게 작동시킬 수 있을 뿐 아니라 120B 파라미터를 지닌 거대 LLM도 구동할 수 있다는 점을 강조했습니다. 젠슨 황 엔비디아 CEO는 RTX 스파크가 장착된 노트북에서 ‘007 퍼스트 라이트’와 ‘포르자 호라이즌 6’를 배터리 전원만으로 구동하는 모습을 선보였는데, 이는 기존의 스냅드래곤 기반의 윈도우 ARM(Windows on ARM) 노트북에서는 생각하기 어려웠던 게임 성능으로 마이크로소프트가 밀고 있는 윈도우 ARM의 약점을 상당 부분 극복한 모습입니다. 마이크로소프트는 RTX 스파크 개발을 위해 엔비디아와 긴밀히 협업했고 에이서(Acer), ASUS, 레노버(Lenovo), 델(Dell), HP, MSI 등 주요 PC 제조사와 함께 마이크로소프트의 서피스 라인업에도 RTX 스파크 모델을 넣어 고성능 윈도우 ARM PC 개발 의지를 보여줬습니다. 그런데 이날 공개된 RTX 스파크 노트북을 보면 그렇게 두꺼운 제품이 아니라는 점을 쉽게 알 수 있습니다. DGX 스파크의 GB10 칩이 약 140W의 열 설계 전력(TDP)을 가진다는 점을 고려할 때, RTX 스파크는 엔비디아의 노트북 전력 효율 기술인 MAX-Q를 적극적으로 활용해 TDP를 낮추고 최소 두께 14mm의 슬림한 디자인을 구현한 것으로 보입니다. MAX-Q는 단순히 클럭을 강제로 낮추는 방식을 넘어, 최적화 기술을 집약한 기술입니다. 게임 실행 시 AI 텔레메트리(AI Telemetry)가 GPU와 CPU 워크로드를 실시간으로 분석하면, CPU 옵티마이저는 불필요한 전력 소모를 줄이기 위해 CPU를 ‘최고 효율 주파수’로 동적으로 조정합니다. 이때 절약된 전력은 다이나믹 부스트(Dynamic Boost)를 통해 GPU로 재배분됩니다. GPU 차원에서도 파워 게이팅(Power Gating)을 통해 사용되지 않는 내부 블록을 비활성화하고, 워크로드에 맞춰 클럭을 미세 조정합니다. 여기에 DLSS 4.5를 통해 실제 렌더링 부하를 줄여서 전력 소모와 발열을 최소화하면서도 성능을 유지할 수 있습니다. 물론 이론적으로 MAX-Q가 적용된 N1x의 성능이 TDP 140W이 기본인 GB10와 대등하지는 않을 것으로 보입니다. 일부 성능 저하는 감수해야 하지만, 충분한 휴대성을 보장하면서도 AAA급 고사양 게임과 대규모 언어 모델(LLM) 구동이 가능하다는 것은 개발자와 고성능 기기를 쓰는 사용자들에게 상당한 장점입니다. 다만 이날 보여준 128GB 모델만 있을 경우 가격은 매우 비쌀 가능성이 높습니다. DGX 스파크의 공식 가격이 4699달러(원래 3999달러였으나 메모리 가격 상승으로 인상)이며, 국내에서는 부가세를 포함해 더 비싼 가격에 판매되는 점을 고려하면, 노트북 버전인 RTX 스파크 제품은 훨씬 비싸질 가능성이 높습니다. 이런 점을 감안하면 64GB, 32GB 모델도 있을 가능성이 있으나 당장에 공개된 내용은 없습니다. 아무튼 높은 가격을 생각하면 RTX 스파크의 주요 경쟁자는 애플의 맥북 프로(특히 M5 맥스 시리즈)가 될 것으로 보입니다. 다만 현재 DGX 스파크 가격을 생각할 때 RTX 스파크 노트북은 128GB 모델 기준 맥북 프로 M5 맥스 모델보다 비쌀 가능성이 높아 보입니다. 이렇게 비싼 제품을 게임만 하려고 사는 경우는 거의 없을 것입니다. 따라서 비싸도 업무에 사용해야만 하는 특별한 용도, 예를 들어 LLM(대규모 언어 모델)이나 그래픽 작업 성능이 중요한 요소가 될 것으로 보입니다. 이 시장에서 유력한 경쟁 상태인 맥북 프로 M5 맥스도 128GB 모델은 120B 파라미터 급 LLM 구동이 가능하지만, RTX 스파크는 6144개의 CUDA 코어와 텐서 코어를 활용한 FP4(4비트 양자화) 연산 능력과 최대 1페타플롭스(Petaflop)의 연산 성능으로 토큰 속도에서 우위를 점할 가능성이 있습니다. 엔비디아는 RTX 스파크를 개인용 에이전트를 위한 플랫폼으로 소개하고 있으며 로컬 컴퓨터에서 120B LLM을 100만 토큰의 컨텍스트로 구동하거나, 90GB 이상의 거대한 3D 장면을 렌더링하고, 12K 영상 편집 및 4K AI 비디오 생성을 할 수 있습니다. 물론 실제 성능과 가성비는 제품이 실제 출시되고 가격이 공개되어야 제대로 평가할 수 있을 것입니다. 황 CEO는 “PC는 다시 태어나고 있다. 40년 동안 우리는 앱을 실행하고 클릭하고 타이핑했지만, 이제 RTX 스파크와 윈도우를 통해 우리는 요청하고 PC가 작업을 수행한다”며, RTX 스파크가 로컬 에이전트, 최전방 모델, 크리에이티브 워크플로우, RTX 게임을 하나의 노트북에 통합한 ‘새로운 PC’라고 강조했습니다. 그의 포부처럼 실제로 RTX 스파크가 PC의 재창조가 될지 아니면 특수 용도로 사용하는 비싼 장비로 남게 될지 결과가 주목됩니다.
  • “캐릭터 얼굴이 왜 이래?”…박수 칠 줄 알았는데, DLSS 5 논란에 당혹스러운 엔비디아 [고든 정의 TECH+]

    “캐릭터 얼굴이 왜 이래?”…박수 칠 줄 알았는데, DLSS 5 논란에 당혹스러운 엔비디아 [고든 정의 TECH+]

    엔비디아는 ‘GTC 2026’ 행사를 통해 여러 가지 흥미로운 신기술을 소개했습니다. 가장 주목을 끈 대목은 올해 출시를 준비 중인 차세대 AI CPU+GPU 시스템인 베라 루빈과, 새로 공개한 Groq의 3세대 LPU 시스템입니다. 해당 LPU는 AI 추론을 빠르게 처리하는 전용 가속기로, 베라 루빈 시스템과 함께 사용할 경우 전체 AI 처리 성능을 크게 끌어올릴 수 있어 주목받고 있습니다. 다만 이번에도 RTX 50 시리즈 이후 출시될 차세대 일반 소비자용 GPU에 대한 구체적인 소개는 빠졌습니다. 최근 메모리 공급과 파운드리 수급 문제 등이 이어지면서 소비자용 GPU 출시가 지연될 가능성도 높아지는 가운데 아쉬운 대목입니다. 하지만 대신 AI 그래픽 기술인 DLSS 5가 공개되며 큰 관심을 끌었습니다. DLSS 4.5 이전까지 DLSS 기술은 이미 GPU가 렌더링한 그래픽을 AI를 이용해 더 선명한 이미지로 보정하거나, 프레임과 프레임 사이에 새로운 화면을 만들어 넣어 게임 속도를 높이는 데 집중해 왔습니다. 하지만 DLSS 5는 뉴럴 렌더링(neural rendering) 기술을 적용해 그래픽 생성 단계부터 AI가 관여해 게임 그래픽을 더 근본적으로 바꿀 수 있습니다. 물체의 기본 형태는 유지하면서도, 표면의 질감이나 조명, 디테일과 같은 시각적 요소를 AI가 다시 구성하는 방식입니다. 그 결과 이전보다 훨씬 현실적인 그래픽과 인체 표현이 가능해졌다는 것이 엔비디아의 설명입니다. 이날 무대에 오른 젠슨 황 CEO는 DLSS 5를 “프로그래머블 셰이더 이후 컴퓨터 그래픽스의 재발명”이자 “그래픽의 GPT 모먼트”라고 평가하며, 2018년 실시간 하드웨어 레이 트레이싱 이후 가장 큰 혁신이라고 강조했습니다. 실제로 공개된 영상과 이미지를 보면 DLSS 5 적용 시 과거와는 다른 수준의 세밀한 캐릭터 묘사가 두드러집니다. 보통 이런 신기술이 공개되면 사람들은 환호하고 여기저기서 박수가 쏟아지기 마련입니다. 하지만 기대와 달리, 발표 직후 DLSS 5는 예상치 못한 논쟁에 휩싸이게 됩니다. 일부 캐릭터 표현이 이른바 ‘AI 슬롭(slop)’처럼 보인다는 비판이 제기된 것입니다. AI 슬롭은 생성형 AI가 만들어낸 저품질·무의미한 콘텐츠를 가리키는 표현으로, 원래 ‘음식물 찌꺼기’를 뜻하는 단어에서 유래했습니다. DLSS 5에서는 캐릭터 얼굴이 과도하게 보정되면서 마치 AI 필터를 적용한 것처럼 어색해 보인다는 지적과, 게임마다 비슷한 느낌이 난다는 비판이 이어지고 있습니다. 심지어 전혀 다른 이미지에 DLSS 5를 적용했다는 식의 패러디까지 등장하고 있는 상황입니다. 실제 사례를 보면 ‘레지던트 이블 레퀴엠’에서는 입술이 두꺼워지고 광대뼈가 강조되면서 얼굴 구조 자체가 바뀐 것처럼 보인다는 지적이 나오고 있습니다. ‘호그와트 레거시’에서는 노인의 주름 표현이 과도해 오히려 부자연스럽고 기괴하다는 평가도 있습니다. 여기에 프레임마다 AI가 이미지를 생성하는 과정에서 장면 간 미묘한 어긋남이 발생해 영상이 어색하게 느껴진다는 문제도 제기됩니다. 이러한 현상은 단순히 화질이 떨어지는 문제가 아니라, 캐릭터의 얼굴이나 장면의 분위기 자체가 달라지는 ‘의미 수준의 왜곡(semantic distortion)’에 가깝습니다. 이에 대해 젠슨 황 CEO는 “게이머들이 완전히 틀렸다”고 반박하며, 모든 결과는 개발자의 통제 하에 있다고 강조했습니다. 실제 적용 수준과 방식은 개발자가 결정하며, 사용자 역시 옵션을 통해 DLSS 5 적용 여부를 선택할 수 있다는 설명입니다. 이 같은 논쟁은 DLSS 초기 논쟁과도 비교됩니다. 당시에는 이미지가 뿌옇게 흐려지는 블러(blur), 빠르게 움직이는 물체 뒤에 잔상이 남는 고스트(ghost), 화면이 미세하게 흔들리거나 깜빡이는 플리커링(flickering) 같은 문제가 있었습니다. 이는 이미지 품질을 높이거나 새로운 프레임을 만들어내는 과정에서 발생하는 오류였습니다. 이후 DLSS 3와 4를 거치며 이러한 문제들은 상당 부분 개선되었습니다. 반면 DLSS 5에서 제기되는 논란은 단순한 그래픽 품질 문제가 아니라, 아예 다른 그래픽이 만들어지는 것 아니냐는 데 있습니다. 즉, 같은 장면을 더 선명하게 보여주는 것이 아니라 AI가 장면을 새롭게 해석해 바꿔버리는 것에 대한 거부감이 핵심입니다. 결국 DLSS 5는 단순한 그래픽 향상 기술을 넘어, AI가 게임의 시각적 결과를 어디까지 바꿀 수 있는가라는 근본적인 질문을 던지고 있습니다. AI 왜곡 못지 않은 논쟁은 접근성입니다. RTX 50 시리즈의 가격이 높게 책정된 데다, AI 수요 증가로 인해 실제 시장 가격은 출시가보다 더 상승한 상태입니다. 그 결과 많은 소비자들이 새로운 그래픽 카드 구매를 미루고 있으며, 여전히 구형 GPU를 사용하는 경우도 적지 않습니다. 이로 인해 상당수 사용자들이 DLSS 4조차 충분히 활용하지 못하는 상황에서, 훨씬 더 많은 연산 자원을 요구하는 DLSS 5가 공개되면서 ‘그림의 떡’이라는 평가도 나오고 있습니다. 실제로 이날 시연에는 최고급 그래픽 카드 RTX 5090이 두 장이 사용됐습니다. 엔비디아는 가을 정식 출시 전에 한 장의 그래픽 카드에서도 돌아갈 수 있도록 개선하겠다고 발표했지만, RTX 5090 한 장으로도 간신히 돌아가는 수준이 아니냐는 의구심이 제기되고 있습니다. 현재 200만원 넘는 RTX 5080을 구매한 소비자조차도 쉽게 사용할 수 없는 것 아니냐는 우려가 나오는 대목입니다. 아무리 혁신적인 기술이라도 많은 사람들이 접근하기 어렵다면 그 의미는 제한적일 수밖에 없습니다. AI 그래픽 기술의 진정한 확산은 성능뿐 아니라 가격과 접근성까지 함께 해결될 때 가능할 것입니다.
  • 꿩 대신 닭? 새 그래픽 카드 대신 DLSS 4.5와 RTX AI 업데이트 들고나온 엔비디아

    꿩 대신 닭? 새 그래픽 카드 대신 DLSS 4.5와 RTX AI 업데이트 들고나온 엔비디아

    본래 엔비디아는 기본형 그래픽 카드를 출시한 후 업데이트 버전인 Ti나 슈퍼(S) 버전을 추가 공개하는 식으로 다음 세대 제품이 나올 때까지 신제품을 출시해 왔다. 하지만 올해 CES 2026에서는 새로운 게이밍 그래픽 카드가 등장하지 않았다. 대신 엔비디아는 일반 소비자를 위해 DLSS 4.5와 RTX AI 업데이트 기능을 제시했다. DLSS(Deep Learning Super Sampling) 기술은 AI 기능을 이용해 게임에서 초고해상도 업스케일링 (DLSS Super Resolution), 프레임 생성 (DLSS Frame Generation), 광선 재구성 (DLSS Ray Reconstruction) 등의 기술을 구현한다. 이는 AI로 게임 성능을 높이는 것을 의미한다. 엔비디아는 재작년 RTX 50 시리즈를 공개했다. 사실 RTX 50 그래픽 카드는 전작인 RTX 40과 비교해 기본 성능은 별 차이가 없었다. 하지만 함께 공개된 DLSS 4에서 RTX 50 그래픽 카드에 x3, x4 멀티프레임 생성 (MPG)을 더하면서 차이점을 만들었다. RTX 40 그래픽 카드는 프레임 사이에 AI 생성 이미지를 한 장 넣을 수 있다. 반면 RTX 50은 2장, 3장 넣을 수 있다. 따라서 RTX 40이 초당 30 프레임 + 30 프레임 생성이 가능한 반면 RTX 50은 초당 30 프레임 + 90 프레임 생성이 가능해 체감 속도가 2배 빠르다. 이번 DLSS 4.5에서는 x6 멀티프레임 생성 기능이 새롭게 지원돼 RTX 40과 체감 속도가 최대 3.5배 차이가 날 수 있게 됐다. 예를 들어 30 프레임 생성하는 게임에서 150 프레임을 추가해 180 프레임으로 게임을 즐길 수 있다. 새로운 그래픽 카드를 들고나온 것은 아니지만, 지금 판매하는 RTX 50 시리즈의 차별성을 더 높일 수 있는 업데이트인 셈이다. 하지만 이렇게 인공지능 이미지 생성을 활용할 경우 실제 이미지와 달라지면서 이미지 품질이 떨어지거나 왜곡되는 문제가 생길 수 있다. DLSS 4.5에서는 2세대 트랜스포머 슈퍼 레졸루션 기능이 적용돼 이미지 품질 역시 개선했다. 그리고 동적 멀티 프레임 생성 기능이 적용돼 상황에 따라 과도한 프레임 생성 대신 이미지 품질 개선에 주력할 수 있게 됐다. 따라서 사용자들은 게임 속도와 이미지 품질 두 마리 토끼를 한 번에 잡을 수 있게 됐다는 것이 엔비디아의 설명이다. 2세대 트랜스포머 슈퍼 레졸루션 기능은 RTX 20/30/40 그래픽 카드에서도 사용이 가능하다. 다만 상당한 양의 메모리와 AI 연산 자원을 사용하기 때문에 오히려 속도는 줄어들 수 있다. 하지만 RTX 40/50에서 이미 프레임 생성으로 속도가 빨라진 상황에서 조금 속도를 줄이고 이미지 품질을 개선하는 것이 체감상 더 나은 선택이 될 수 있어 사용자에게 이득이 될 것으로 보인다. 엔비디아는 컴퓨터에서 로컬 LLM을 구동하거나 스테이블 디퓨전 등을 이용해 이미지를 생성하는 데 도움을 주는 RTX AI 기능도 업데이트했다. 이것 역시 RTX 50 사용자들이 가장 큰 혜택을 볼 수 있다. NVFP4 (NVIDIA Floating Point 4) 연산을 RTX 50 그래픽 카드에서만 지원하기 때문이다. RTX 50 사용자들은 NVFP4/8 기능을 이용해 GPT-OSS, Nemotron Nano V2 등 주요 모델에서 최대 40% 성능 향상과 스테이블 디퓨전 ComfyUI 내 Flux.1, Flux.2 모델에서 최대 4.6배 성능 향상을 기대할 수 있다. 이는 내 컴퓨터에서 돌아가는 로컬 LLM이나 이미지/영상 생성 기능을 높일 수 있다는 것이다. AI 연산용으로 그래픽 카드를 사용하는 경우 더 혜택을 볼 수 있다. 그렇다고 해서 RTX 40 이전 그래픽 카드 사용자에게 혜택이 전혀 없는 것은 아니다. 이번 RTX AI 업데이트에는 시스템 메모리(RAM)로 작업 내용을 분산(Offload)하는 최적화도 포함돼 있다. 즉 VRAM이 부족할 때 시스템 RAM을 활용할 수 있어 성능 저하를 최소화하면서 대형 모델을 실행할 수 있다는 이야기다. 8GB VRAM 카드로도 300억 개 이상의 파라미터를 가진 거대 모델을 돌릴 수 있는 길을 열었기 때문에 RTX 30/40 사용자나 RTX 50이라도 8/12GB VRAM 사용자에게 이득이 될 수 있다. RTX 비디오 및 슈퍼 레졸루션 기능 역시 RTX 50 이전 모델에서도 사용할 수 있다. 처음부터 소비자용 그래픽 카드로 4K 영상을 만들면 너무 시간이 오래 걸리기 때문에 RTX AI는 720p로 빠르게 영상을 생성한 뒤, RTX Video 기술로 실시간 4K 업스케일링 하는 방식을 사용한다. 덕분에 로컬 컴퓨터에서 AI 영상 제작이 좀 더 수월해졌다. 종합하면 이번 소프트웨어 업데이트는 이미 판매 중인 RTX 50 사용자에게 가장 큰 혜택을 줄 것으로 예상된다. 구형 그래픽 카드 사용자도 다소 이득을 보게 되나 상대적으로 이득 폭을 적게 해 RTX 50 판매를 늘리려는 의도도 담겨 있어 보이지만, 사실 현재 엔비디아의 매출에서 게임용 그래픽 카드는 큰 비중을 차지하지 않는다. 따라서 이런 차이는 RTX 40·30·20 제품의 하드웨어적 한계로 풀이된다. 더구나 메모리 가격 폭등에 이어 RTX 50 그래픽 카드 가격도 오르고 있어 이번 업데이트가 실제 판매량 증가로 이어질지는 미지수다. 다만 이번 업데이트를 통해 이미 시중에 풀린 RTX 그래픽 카드 사용자들은 모두 혜택을 보게 되고 게임뿐 아니라 AI 작업에서 엔비디아 그래픽 카드를 더 잘 활용할 수 있게 되는 만큼 앞으로 생성형 AI와 게임 AI 생태계에서 엔비디아의 입지를 공고히 할 수 있을 것으로 예상된다.
  • 꿩 대신 닭? 새 그래픽 카드 대신 DLSS 4.5와 RTX AI 업데이트 들고나온 엔비디아 [고든 정의 TECH+]

    꿩 대신 닭? 새 그래픽 카드 대신 DLSS 4.5와 RTX AI 업데이트 들고나온 엔비디아 [고든 정의 TECH+]

    본래 엔비디아는 기본형 그래픽 카드를 출시한 후 업데이트 버전인 Ti나 슈퍼(S) 버전을 추가 공개하는 식으로 다음 세대 제품이 나올 때까지 신제품을 출시해 왔다. 하지만 올해 CES 2026에서는 새로운 게이밍 그래픽 카드가 등장하지 않았다. 대신 엔비디아는 일반 소비자를 위해 DLSS 4.5와 RTX AI 업데이트 기능을 제시했다. DLSS(Deep Learning Super Sampling) 기술은 AI 기능을 이용해 게임에서 초고해상도 업스케일링 (DLSS Super Resolution), 프레임 생성 (DLSS Frame Generation), 광선 재구성 (DLSS Ray Reconstruction) 등의 기술을 구현한다. 이는 AI로 게임 성능을 높이는 것을 의미한다. 엔비디아는 재작년 RTX 50 시리즈를 공개했다. 사실 RTX 50 그래픽 카드는 전작인 RTX 40과 비교해 기본 성능은 별 차이가 없었다. 하지만 함께 공개된 DLSS 4에서 RTX 50 그래픽 카드에 x3, x4 멀티프레임 생성 (MPG)을 더하면서 차이점을 만들었다. RTX 40 그래픽 카드는 프레임 사이에 AI 생성 이미지를 한 장 넣을 수 있다. 반면 RTX 50은 2장, 3장 넣을 수 있다. 따라서 RTX 40이 초당 30 프레임 + 30 프레임 생성이 가능한 반면 RTX 50은 초당 30 프레임 + 90 프레임 생성이 가능해 체감 속도가 2배 빠르다. 이번 DLSS 4.5에서는 x6 멀티프레임 생성 기능이 새롭게 지원돼 RTX 40과 체감 속도가 최대 3.5배 차이가 날 수 있게 됐다. 예를 들어 30 프레임 생성하는 게임에서 150 프레임을 추가해 180 프레임으로 게임을 즐길 수 있다. 새로운 그래픽 카드를 들고나온 것은 아니지만, 지금 판매하는 RTX 50 시리즈의 차별성을 더 높일 수 있는 업데이트인 셈이다. 하지만 이렇게 인공지능 이미지 생성을 활용할 경우 실제 이미지와 달라지면서 이미지 품질이 떨어지거나 왜곡되는 문제가 생길 수 있다. DLSS 4.5에서는 2세대 트랜스포머 슈퍼 레졸루션 기능이 적용돼 이미지 품질 역시 개선했다. 그리고 동적 멀티 프레임 생성 기능이 적용돼 상황에 따라 과도한 프레임 생성 대신 이미지 품질 개선에 주력할 수 있게 됐다. 따라서 사용자들은 게임 속도와 이미지 품질 두 마리 토끼를 한 번에 잡을 수 있게 됐다는 것이 엔비디아의 설명이다. 2세대 트랜스포머 슈퍼 레졸루션 기능은 RTX 20/30/40 그래픽 카드에서도 사용이 가능하다. 다만 상당한 양의 메모리와 AI 연산 자원을 사용하기 때문에 오히려 속도는 줄어들 수 있다. 하지만 RTX 40/50에서 이미 프레임 생성으로 속도가 빨라진 상황에서 조금 속도를 줄이고 이미지 품질을 개선하는 것이 체감상 더 나은 선택이 될 수 있어 사용자에게 이득이 될 것으로 보인다. 엔비디아는 컴퓨터에서 로컬 LLM을 구동하거나 스테이블 디퓨전 등을 이용해 이미지를 생성하는 데 도움을 주는 RTX AI 기능도 업데이트했다. 이것 역시 RTX 50 사용자들이 가장 큰 혜택을 볼 수 있다. NVFP4 (NVIDIA Floating Point 4) 연산을 RTX 50 그래픽 카드에서만 지원하기 때문이다. RTX 50 사용자들은 NVFP4/8 기능을 이용해 GPT-OSS, Nemotron Nano V2 등 주요 모델에서 최대 40% 성능 향상과 스테이블 디퓨전 ComfyUI 내 Flux.1, Flux.2 모델에서 최대 4.6배 성능 향상을 기대할 수 있다. 이는 내 컴퓨터에서 돌아가는 로컬 LLM이나 이미지/영상 생성 기능을 높일 수 있다는 것이다. AI 연산용으로 그래픽 카드를 사용하는 경우 더 혜택을 볼 수 있다. 그렇다고 해서 RTX 40 이전 그래픽 카드 사용자에게 혜택이 전혀 없는 것은 아니다. 이번 RTX AI 업데이트에는 시스템 메모리(RAM)로 작업 내용을 분산(Offload)하는 최적화도 포함돼 있다. 즉 VRAM이 부족할 때 시스템 RAM을 활용할 수 있어 성능 저하를 최소화하면서 대형 모델을 실행할 수 있다는 이야기다. 8GB VRAM 카드로도 300억 개 이상의 파라미터를 가진 거대 모델을 돌릴 수 있는 길을 열었기 때문에 RTX 30/40 사용자나 RTX 50이라도 8/12GB VRAM 사용자에게 이득이 될 수 있다. RTX 비디오 및 슈퍼 레졸루션 기능 역시 RTX 50 이전 모델에서도 사용할 수 있다. 처음부터 소비자용 그래픽 카드로 4K 영상을 만들면 너무 시간이 오래 걸리기 때문에 RTX AI는 720p로 빠르게 영상을 생성한 뒤, RTX Video 기술로 실시간 4K 업스케일링 하는 방식을 사용한다. 덕분에 로컬 컴퓨터에서 AI 영상 제작이 좀 더 수월해졌다. 종합하면 이번 소프트웨어 업데이트는 이미 판매 중인 RTX 50 사용자에게 가장 큰 혜택을 줄 것으로 예상된다. 구형 그래픽 카드 사용자도 다소 이득을 보게 되나 상대적으로 이득 폭을 적게 해 RTX 50 판매를 늘리려는 의도도 담겨 있어 보이지만, 사실 현재 엔비디아의 매출에서 게임용 그래픽 카드는 큰 비중을 차지하지 않는다. 따라서 이런 차이는 RTX 40·30·20 제품의 하드웨어적 한계로 풀이된다. 더구나 메모리 가격 폭등에 이어 RTX 50 그래픽 카드 가격도 오르고 있어 이번 업데이트가 실제 판매량 증가로 이어질지는 미지수다. 다만 이번 업데이트를 통해 이미 시중에 풀린 RTX 그래픽 카드 사용자들은 모두 혜택을 보게 되고 게임뿐 아니라 AI 작업에서 엔비디아 그래픽 카드를 더 잘 활용할 수 있게 되는 만큼 앞으로 생성형 AI와 게임 AI 생태계에서 엔비디아의 입지를 공고히 할 수 있을 것으로 예상된다.
  • 인텔 부활의 신호탄 될까?…18A 및 팬서 레이크 양산 시작 [고든 정의 TECH+]

    인텔 부활의 신호탄 될까?…18A 및 팬서 레이크 양산 시작 [고든 정의 TECH+]

    인텔이 애리조나에 위치한 팹 52(Fab 52)에서 차세대 반도체 공정인 18A 공정의 양산을 시작했다고 발표했습니다. 18A 공정은 인텔의 첫 2nm 급 공정입니다. 본래 20A에서 도입하기로 했던 게이트 올 어라운드(GAA) 트랜지스터 기술인 리본펫(RibbonFET)과 후면 전력 공급 기술(BSPDN)인 파워비아(PowerVia)를 18A에서 적용할 예정입니다. 리본펫 기술은 트랜지스터를 더 작게 만들어도 제 성능을 낼 수 있게 도와주고 파워비아 기술은 전선 배치를 단순화시켜 트랜지스터 밀도를 높이면서 저항을 줄여 성능을 높일 수 있습니다. 인텔에 따르면 파워비아 하나만으로도 트랜지스터 밀도를 10% 높이고 저항은 30%나 줄여 전력 소모를 크게 줄일 수 있습니다. 여기에 최신 EUV 리소그래피 공정을 도입했기 때문에 18A 공정은 인텔의 이전 공정보다 트랜지스터 밀도와 성능 모두 크게 개선되었을 것을 기대됩니다. 18A가 인텔이 주장한 것처럼 성능을 크게 높일 수 있을지 검증하는 첫 무대는 노트북 CPU인 팬서 레이크(Panther Lake)가 될 예정입니다. 인텔이 함께 공개한 내용에 따르면 팬서 레이크는 크게 세 가지 버전으로 출시됩니다. 8코어(4P+4E) CPU와 4코어 GPU, 16코어 CPU(4P+8E+4LPE) CPU와 4코어 GPU, 그리고 16코어 CPU(4P+8E+4LPE)와 12코어 GPU가 그것입니다. 이 가운데 CPU 부분은 인텔 18A 공정으로 제조되고 나머지는 인텔 3과 TSMC 공정을 이용합니다. CPU 타일을 구성하는 고성능 코어(P-코어)의 코드네임은 쿠거 코브(Cougar Cove)이고 고효율 코어(E-코어)의 코드네임은 다크몬트(Darkmont)인데, 여기에 전력 소모를 더 줄인 저전력 다크몬트 E코어(LPE)까지 총 세 가지 형태의 코어를 탑재해 상황에 따라 초저전력부터 고성능까지 다양한 대응이 가능합니다. 인텔이 공개한 슬라이드를 보면 팬서 레이크는 특히 전력 절감 효과가 뛰어납니다. 이전 세대인 루나 레이크 및 애로우 레이크 H와 비교해서 싱글 스레드 성능은 같은 전력 소모에서 10% 정도 높아진 수준이나 같은 성능을 기준으로 했을 때는 최대 40%의 전력을 절감할 수 있습니다. 멀티 스레드의 경우에는 전력 소모에서 전 세대 대비 50%의 성능 향상, 혹은 같은 성능에서 30% 전력 효율 향상이 있습니다. 이는 코어 숫자가 늘어나고 저전력 고효율 코어를 추가한 덕분으로 보입니다. 또 앞서 말한 것처럼 18A 미세공정과 파워비아를 통한 저항 감소도 크게 작용한 수치로 보입니다. 팬서 레이크에서 독특한 부분 중 하나는 Xe3 내장 그래픽의 구성입니다. 4코어 버전과 12코어 버전이 있는데, 과거 루나 레이크가 8코어 혹은 7코어였던 것과 비교해서 큰 변화로 버전에 따른 성능 차이가 클 것으로 예상됩니다. Xe3 내장 그래픽은 전 세대보다 성능을 더 높여 루나 레이크보다 50% 정도 성능이 높아졌다고 했는데, 12코어 기준이라면 코어 한 개의 성능은 이전세대와 큰 차이가 없다는 뜻이 됩니다. 이 경우 4코어 버전의 게임 성능은 낮을 것으로 예상됩니다. 이런 점을 감안하면 아마도 4코어 GPU 모델은 가격을 낮춘 보급형으로 생각되고 8코어 CPU + 4코어 GPU는 태블릿처럼 얇고 가벼운 제품에 들어가는 저전력 모델로 추정됩니다. 주력 모델은 고성능 제품인 16코어 CPU + 12코어 GPU가 될 것으로 예상되는데, 특이한 점은 LPDDR5x 9600만 지원한다는 것입니다. 다른 모델은 기존의 노트북용 DDR5 메모리도 지원할 수 있는 것과 대조적입니다. LPDDR5x 9600처럼 빠른 고성능 메모리만 사용하는 이유는 12코어 Xe3 GPU가 필요한 대역폭을 원활하게 확보하기 위한 것으로 생각됩니다. 고성능 GPU일수록 빠른 메모리가 필요하기 때문입니다. 여기에 12코어 Xe3 GPU는 16MB의 대용량 L2 캐시를 탑재해 고성능 연산에 필요한 메모리를 확보했습니다. 따라서 내장 그래픽임에도 높은 성능을 낼 수 있을 것으로 예상됩니다. 또 다른 특징은 AI를 이용해서 여러 개의 프레임을 생성하는 멀티 프레임 생성(MPG) 기능으로 인텔이 공개한 슬라이드를 보면 아마도 x3(하나의 프레임을 3배로 늘려 속도를 3배처럼 높이는 방식) 멀티 프레임 생성이 가능한 것으로 보입니다. 다만 인텔 AI 기술인 XeSS는 엔비디아의 DLSS처럼 지원되는 게임이 많지 않는다는 것이 단점입니다. 이날 공개된 내용만 보면 인텔 팬서 레이크는 충분한 경쟁력을 지닌 차세대 프로세서로 생각됩니다. 그리고 만약 예정대로 18A 공정으로 CPU 타일을 원활하게 공급할 수 있다면 인텔 파운드리의 지속 가능성에 대한 의구심도 상당 부분 덜어낼 수 있을 것으로 생각됩니다. 다만 그렇지 못하다면 인텔의 미래는 매우 어두워질 것입니다. 과연 어떤 쪽으로 결론이 날지는 내년 초 팬서 레이크가 실제 공개되면 알 수 있을 것입니다.
  • 닌텐도 ‘스위치2’ 후속작 징크스 뛰어넘을까? [와쿠와쿠 도쿄]

    닌텐도 ‘스위치2’ 후속작 징크스 뛰어넘을까? [와쿠와쿠 도쿄]

    “10곳에 응모했어요. 당첨돼서 너무 기뻐요.” 지난 5일 도쿄 아키하바라에서 만난 40대 회사원 남성은 흥분을 감추지 못했습니다. 이날은 전 세계 누적 1억 5000만 대 이상이 팔리며 콘솔 게임의 정의 자체를 바꿔놓은 닌텐도 ‘스위치’의 후속작, ‘스위치2’가 8년만에 공식 발매된 날이었거든요. 이번 스위치2는 외형만 보면 기존 모델과 크게 다르지 않아요. 조이콘 디자인도 유사하고 조작 방식도 익숙했죠. 하지만 속은 완전히 달라졌습니다. 인공지능(AI) 기반 그래픽 보정 기술 DLSS가 적용된 엔비디아의 칩이 탑재됐는데요, 전작 대비 그래픽 성능이 10배나 향상됐다고 합니다. 기존 스위치로는 돌아가지 않는 고성능 게임들도 원활하게 돌아가는 그야말로 ‘휴대용 게임기 역사상 가장 뛰어난 그래픽이 구현된다’는 게 회사 측의 설명이죠. 젠슨 황 엔비디아 최고경영자(CEO)는 발매 당일 홈페이지에 게재된 축하 영상을 통해 “이 칩은 이전 제품과 완전히 다르며, 기술의 기적”이라고 강조했죠. 닌텐도 역시 이번 스위치2를 ‘정통 진화’(전통을 유지하며 성능을 개선한 방식)라며 자신감을 드러냈고, 연간 판매 목표도 1500만 대로 잡았습니다. 하지만 늘 그랬듯 기기 자체가 진화했다고 해서 성공이 보장되는 건 아니에요. 닌텐도는 과거 DS의 3DS, Wii의 WiiU에서 후속작 징크스를 겪은 바 있죠. 두 제품 모두 기술은 진보했지만, 콘텐츠가 따라주지 않아 전작만큼의 대중적 인기를 이어가진 못했어요. 실제 3DS는 7594만 대가 팔려 전작인 닌텐도DS(1억 5402만 대)에 미치지 못했고, WiiU는 1356만 대로, Wii(1억 163만 대)보다 크게 부진했어요. WiiU는 닌텐도의 홈 콘솔 가운데 가장 낮은 판매량을 기록했죠. ‘스위치2’는 이 징크스를 넘어설 수 있을까요. 이번에는 콘텐츠 전략부터 달라졌습니다. 닌텐도는 초기부터 외부 게임사들과의 협업을 강화했어요. 자체 타이틀인 ‘슈퍼마리오’와 ‘젤다의 전설’만으로는 부족하다는 걸 인식한셈이죠. 실제 니혼게이자이신문에 따르면 닌텐도의 자사 타이틀 매출 비중은 1년 새 8.2%포인트 줄어 73%까지 내려갔다고 합니다. 아울러 ‘1가구 1대’를 넘은 ‘1인 1대’ 보급 전략을 내세웠어요. 집 안에서 하나의 게임기를 공유하던 시대에서, 가족 구성원 각자가 하나씩 갖는 ‘스위치 시대’를 열겠다는 목표입니다. 다만 가격이 변수가 될 것으로 보이는데요, 닌텐도 측도 “고가 정책에 따른 초반 보급의 허들이 있다”고 인정했죠. 실제 스위치2는 일본 내수 전용 모델이 4만 9980엔, 다국적 대응 모델은 6만 9980엔으로 기존 스위치보다 1만 7000엔 가까이 올랐어요. 한국에서도 스위치(36만 원)의 약 1.8배에 해당하는 64만 8000원이라는 가격이 책정됐지요. 외부 변수도 남아 있습니다. 닌텐도는 베트남 등 아시아 공장에서 기기를 만들고 있는데, 도널드 트럼프 2기 행정부의 관세 정책으로 수출 비용이 늘어날 가능성이 크거든요. 이와 관련해 닌텐도는 “수백억 엔 단위의 수익성 악화를 예상하고 있다”고 밝혔습니다. 기술은 분명 진화했고, 전략도 달라졌지만, 시장의 반응은 여전히 변수입니다. 초반 분위기는 나쁘지 않습니다. 지난달 말 기준, 일본에서만 스위치2 예약 추첨에 응모한 인원이 220만 명에 달했거든요. 8년 만에 돌아온 스위치2. 닌텐도는 과거의 징크스를 털어내고, 다시 한 번 콘솔 시장의 기준을 새로 쓸 수 있을까요. 마지막 퍼즐은 결국 ‘유저의 선택’이라는 점만은 변함이 없겠지요. ‘와쿠와쿠’(わくわく)는 일본어 의성어로, 무언가 즐거운 일이 생길 것 같아 들뜨고 기대되는 느낌을 표현할 때 쓰입니다. 도쿄에서 보고, 듣고, 느낀 일본의 아기자기하면서도 역동적인 생활 경제 현장을 격주로 연재합니다. 화려한 뉴스의 이면, 숫자로는 보이지 않는 트렌드 속에서 일본이란 나라의 진짜 표정을 들려드립니다.
  • 이번엔 다르다…엔비디아 천하에 도전장 내민 라데온 RX 9070 시리즈 [고든 정의 TECH+]

    이번엔 다르다…엔비디아 천하에 도전장 내민 라데온 RX 9070 시리즈 [고든 정의 TECH+]

    지금은 인공지능(AI)용 그래픽처리장치(GPU)로 더 친숙하지만, 본래 엔비디아의 본업은 게임용 GPU라고 할 수 있습니다. 1990년대 중반에 TNT 시리즈로 파란을 일으키고 2000년대에는 지포스 시리즈로 그래픽 카드 시장을 평정했습니다. 하지만 여기에 도전장을 내민 경쟁자가 있었습니다. 바로 AMD에 인수된 ATI의 라데온 그래픽 카드입니다. 인수 후에도 AMD는 라데온 브랜드를 지금까지 이어오고 있는데, 한때는 지포스의 강력한 경쟁자로 서로 우열을 가리기 힘들만큼 경쟁이 치열했던 시절도 있었습니다. 하지만 시간이 지날수록 라데온 그래픽 카드 제품군은 지포스와 성능 격차가 점점 벌어졌습니다. 결국 최근에 와서는 하이엔드 그래픽 카드 시장에서는 사실상 경쟁을 포기하고 콘솔 게임기 시장과 중급 및 보급형 그래픽 카드 시장에서 명맥을 이어가고 있었습니다. 따라서 소비자도 ‘게임은 지포스’라는 인식이 어느 정도 자리 잡은 상태인데, 이렇게 시장 독점적인 기업이 되다 보니 신제품을 발표할 때마다 가격이 자꾸 비싸지는 문제가 생겼습니다. 여기에 최근 AI 붐으로 엔비디아 그래픽 카드 수요가 크게 늘어났고 서버 GPU 공급이 원활하지 못하자 풍선효과로 AI 연산용으로 사용할 수 있는 고성능 게임용 그래픽 카드까지 수요가 늘어 가격이 더 올라간 상태입니다. 최근 엔비디아는 RTX 50 시리즈를 발표했는데, 초기 공급 물량이 얼마 없고 수요는 넘쳐나 웃돈을 주고도 물건을 구하기 힘든 상황입니다. 최신 게임을 최고 사양을 즐기기 위해서는 수백만 원이나 되는 고가 그래픽 카드를 사야만 하는 상황이 된 것입니다. 이런 상황에서 일부 소비자들은 라데온 그래픽 카드에 눈길을 돌리고 있습니다. 지난 2월 21일 국내 IT 제품 가격 비교 사이트인 다나와리서치에 따르면 1월 라데온 그래픽 카드의 판매량은 1년 전의 두 배에 달하는 14.65%를 기록했습니다. 본래 점유율이 10% 이하였는데, 특별한 신제품 출시 없이도 반등에 성공한 것입니다. RTX 50 시리즈의 가격 폭등과 물량 부족이 그 원인으로 해석되고 있습니다. 이에 더해 AMD는 RDNA4 아키텍처를 이용한 라데온 RX 9070 시리즈를 공개하며 반전의 기회를 엿보고 있습니다. 라데온 RX 9070 XT에 사용한 나비 (Navi) 48 GPU는 엔비디아의 RTX 5070 Ti와 같은 TSMC의 4㎚ 공정을 사용합니다. 다이 사이즈는 356.5㎟인데 RTX 5080/RTX 5070Ti에 사용된 GB203의 378㎟와 비슷하고 트랜지스터 집적도는 539억 개에 달합니다. 64개의 컴퓨트 유닛(CU)를 사용한 라데온 RX 9070 XT의 경쟁 상대는 RTX 5070Ti입니다. 4K 해상도 기준 게임 성능은 AMD의 공식 발표에 따르면 2% 정도 뒤지는 결과를 보여줍니다. 하지만 출시 전부터 반응이 좋은 이유는 가격이 599달러에 불과하기 때문입니다. 공식 가격이 749달러인 RTX 5070 Ti와 비교하면 가격대 성능비가 23%나 높다는 게 AMD의 주장입니다. 더구나 현재 품귀 현상으로 인해 엔비디아 그래픽카드가 공식 가격보다 많이 높아진 상태임을 생각하면 소비자들이 대거 라데온으로 이동할 수 있는 수준의 파격적인 가격 책정입니다. AMD는 RDNA4 아키텍처를 도입하면서 라데온 RX 9070에서 기존의 약점도 상당 부분 극복했습니다. 컴퓨트 유닛의 연산 능력은 전 세대보다 40% 빨라졌고 3세대 레이트레이싱 가속기는 두 빼 빠른 성능을 제공합니다. 엔비디아의 DLSS처럼 AI를 이용해 게임 성능을 높이는 FSR(FidelityFX Super Resolution) 역시 FSR4 버전으로 업데이트되면서 이미지 품질 향상에 하드웨어 가속이 가능해지고 프레임 역시 대폭 높일 수 있게 됐습니다. 이를 적용하면 스페이스 마린 II 같은 일부 게임에서는 최대 3.4배의 성능 향상을 보여줍니다. DLSS4가 최대 4배 정도 게임 성능을 높이는 것과 견줄만한 결과입니다. 물론 여전히 전체 성능에서는 엔비디아가 유리한 게 사실입니다. 다이 사이즈가 거의 비슷한데, RTX 5080보다 한 단계 낮은 성능이라는 점이나 DLSS4보다 한 단계 낮은 AI 이미지 처리 성능, 그리고 아직 FSR이 DLSS처럼 많이 지원되지 않는다는 점 등 여러 가지 약점이 눈에 띄는 게 사실입니다. 그리고 출시에 앞서 공개된 슬라이드를 보면 게임 성능은 RTX 5070Ti와 비슷해도 AI 연산 능력은 훨씬 떨어지는 것으로 보입니다. 하지만 최근 비정상적인 수준의 그래픽 카드 가격 고공행진을 본 소비자들에게 라데온 RX 9070XT/9070의 파격적인 가격은 이 모든 약점을 다 상쇄하고도 남는 장점입니다. 만약 라데온 RX 9070XT/9070이 압도적인 가성비로 시장에서 좋은 반응을 얻는다면 엔비디아 역시 긴장하지 않을 수 없기 때문에 그래픽 카드 시장에서 가격 경쟁 효과를 기대할 수 있습니다. 어느 시장이든 독점은 해롭습니다. AMD의 라데온이 가성비 제품을 통해 시장에 파란을 일으킬 수 있을지 주목됩니다.
  • 엔비디아 지포스 RTX 50, AI GPU시대 열까 [고든 정의 TECH+]

    엔비디아 지포스 RTX 50, AI GPU시대 열까 [고든 정의 TECH+]

    엔비디아가 새해 초 발표한 RTX 50 시리즈(코드네임 블랙웰)을 두고 여러 가지 이야기가 나옵니다. 우선 DLSS4 같은 AI(인공지능) 기능을 제외하면 사실 전 세대인 RTX 40 시리즈와 비교해서 성능이 큰 차이가 없다는 것입니다. 이는 같은 4nm(나노미터·10억분의1m) 공정을 쓴다고 알려질 때부터 예견된 결과이기도 했습니다. RTX 5090에 사용된 GB202 칩은 회로를 구성하는 판인 다이(die) 면적 744㎟에 트랜지스터 집적도는 922억 개인데 반해 RTX 4090에 사용된 AD102 칩은 다이 608㎟, 트랜지스터 집적도 760억 개입니다. 둘 다 엄청난 수의 트랜지스터를 쌓아 올리긴 하지만 RTX 4090이 이전 버전인 RTX 3090 Ti(283억 개)의 두 배 이상인 것과 비교하면 미미한 수준입니다. 8nm 공정에서 4nm 공정으로 이동한 RTX 40 시리즈와 달리 RTX 50 시리즈는 같은 미세 공정을 사용하기 때문입니다. 엔비디아가 3nm 공정 대신 4nm 공정에 남기로 결정한 것은 비용 문제가 크게 작용한 것으로 보입니다. 최신 미세 공정 웨이퍼는 가격이 꽤 비싸기 때문에 엔비디아는 RTX 30 시리즈에서도 8nm 공정에 만족한 바 있습니다. GPU는 꽤 덩치가 크기 때문에 비싼 최신 미세 공정 웨이퍼를 적용할 경우 제조 원가가 크게 오르기 때문입니다. 물론 반도체 미세 공정 자체가 한계에 도달하면서 발전 속도가 느려진 것 역시 무시할 수 없는 이유입니다. 엔비디아가 대안으로 내세운 것은 AI입니다. 엔비디아는 RTX 30 시리즈 이후 AI 기능을 갈수록 강조했는데, RTX 50 시리즈에서는 아예 핵심 기능으로 자리 잡았습니다. 가장 중요한 AI 기능은 물론 DLSS4입니다. DLSS4는 그래픽 이미지 품질을 높이는 것은 물론 동시에 3개의 프레임을 생성하는 다중 프레임 생성(MFG)을 이용해 자원을 많이 소비하지 않으면서 부드러운 영상을 만들 수 있습니다. 검은 신화: 오공의 경우 4K에서 DLSS 제외 성능이 29프레임, DLSS 적용 성능이 243프레임으로 성능을 8배 정도 늘릴 수 있습니다. 다만 앞서 이야기한 것처럼 RTX 50 시리즈의 트랜지스터 집적도가 크게 높아지지 않았기 때문에 DLSS를 제외한 기본 성능은 큰 차이가 없습니다. FP32 기준 RTX 5090의 성능은 RTX 4090보다 27% 높아진 104.8TFLOPS이고 하위 모델들은 그보다 성능 향상 폭이 좁습니다. RTX 4090에서 기본 성능이 두 배 이상 높아진 것과 대조적입니다. 이 부분이 논쟁이 되고 있지만, 사실 앞으로 게임 그래픽과 성능의 중심은 결국 AI가 될 수밖에 게 사실입니다. 반도체 미세 공정의 한계로 다른 방법으로 성능을 높이기 어려워졌기 때문입니다. RTX 50 시리즈의 두 번째 특징은 그래픽을 만드는 핵심인 셰이더 자체에 AI 기능을 통합한 뉴럴 셰이더(Neural Shader)입니다. 기존 셰이더로 만든 그래픽을 AI를 이용해 이미지 품질을 높이고 프레임을 더 생성하게 만들 뿐 아니라 아예 렌더링 단계에서 AI로 성능과 품질을 높이는 기술입니다. 예를 들어 RTX 뉴럴 텍스처 압축(Neural Texture Compression) 기술을 사용하면 AI를 이용해 수천 장의 텍스처를 1분 안에 압축할 수 있습니다. 엔비디아의 주장에 의하면 VRAM을 7배나 아낄 수 있어 메모리 용량을 크게 늘리지 않고도 고해상도 텍스처를 처리할 수 있습니다. 사실적인 얼굴을 생성하는 뉴럴 페이스나 머리카락이나 피부를 더 사실적으로 보이게 하는 AI 기술을 그래픽에 접목한 기술입니다. 뉴럴 렌더링은 앞으로 그래픽 기술의 표준으로 자리 잡을 수도 있습니다. 마이크로소프트(MS)가 아예 다이렉트 X에 뉴럴 렌더링을 지원하기 위해 협동 벡터(cooperative vector) 기술을 포함시키겠다고 발표했기 때문입니다. 윈도우 OS를 위한 게임 API인 다이렉트 X에 뉴럴 랜더링이 들어가면 향후에는 AMD나 인텔 GPU에서도 이를 이용할 수 있게 될 것으로 보입니다. RTX 50 시리즈의 세 번째 특징은 AI 기술을 그래픽에만 적용하는 것이 아니라 게임 내 가상 캐릭터에도 적용한다는 것입니다. ACE(Avatar Cloud Engine)은 AI의 힘을 이용해 게임 내 등장하는 몬스터가 정해진 패턴이 아닌 학습을 통해 적절한 반응을 하도록 만들 수 있습니다. 이를 통해 게이머는 반복적이고 지루한 플레이에서 벗어날 수 있습니다. 다만 이렇게 AI를 게임의 여러 부분에서 활용하는 만큼 AI 연산 자원의 효율적 분배가 중요해지기 때문에 RTX 50 시리즈는 최초로 AI 관리 프로세서를 탑재했습니다. 앞으로 AI가 그래픽은 물론이고 게임의 모든 부분에서 핵심 요소로 자리 잡게 만들겠다는 엔비디아의 구상이 엿보이는 대목입니다. 이외에도 RTX 50 시리즈는 게임 내 폴리곤(3D 입체를 표현하는 데 사용하는 삼각형) 숫자를 5억 개까지 늘려주는 메가 지오메트리 기능이나 게임 반응 속도를 크게 줄여주는 리플렉스 2 기능 등을 포함시켰습니다. 그리고 AI 기능을 통해 성능을 높인 만큼 같은 성능을 기준으로 전력 소모와 발열량을 줄여 노트북 환경에서 더 유리할 것으로 생각됩니다. 현재 최신 미세 공정의 더딘 발전과 갈수록 비싸지는 웨이퍼 가격을 생각하면 아마 RTX 60 시리즈는 더 AI에 의존할 가능성이 높습니다. 물론 AI 기능을 적극 지원하지 않는 게임을 플레이하는 일부 소비자들은 불만을 품을 수 있습니다. 하지만 앞으로 나올 최신 게임이 대부분 AI 기능을 적극 활용할 것이라는 점을 생각하면 대세는 정해진 것과 다를 바 없습니다.
  • 위기의 인텔, ‘2세대 그래픽 카드’로 재도약 가능할까

    위기의 인텔, ‘2세대 그래픽 카드’로 재도약 가능할까

    현재 인텔은 창립 이후 반세기 만에 최대 위기를 맞이하고 있습니다. 2021년 인텔로 복귀하며 야심 찬 IDM 2.0 계획을 발표했던 팻 겔싱어 인텔 최고경영자(CEO)는 역대급 손실과 함께 인텔을 떠났고 그가 추진한 많은 사업들은 진행 여부가 불투명해진 상황입니다. 현재 인텔은 본업인 CPU 사업에서 경쟁력을 잃었고 신규로 진입한 인공지능(AI)나 파운드리, 그래픽 카드 사업도 부진한 상황입니다. 이런 상황에서 인텔은 2세대 독립 그래픽 카드인 인텔 아크 B500 시리즈를 공개했습니다. 코드네임 배틀메이지(Battlemage) GPU는 Xe 2 아키텍처를 적용한 GPU로 인텔 아크 B580과 B570 두 가지 제품으로 출시됐습니다. 두 제품 모두 BMG-G21 GPU를 이용한 것으로 B570는 B580에서 일부 유닛을 제외한 보급형 제품입니다. BMG-G21 GPU는 TSMC의 5㎚(나노미터) 공정으로 제조되었는데, 트랜지스터 집적도는 196억개이며 반도체 다이(die) 사이즈는 272㎟입니다. 반도체 집적도와 성능면에서 엔비디아의 보급형 그래픽 카드인 지포스 RTX 4060을 경쟁 상대로 설정한 것으로 보이는데, 인텔은 아크 B580의 게임 성능이 RTX 4060보다 10% 정도 빠르다고 주장합니다. 하지만 인텔의 1세대 아크 그래픽 카드는 판매량이 미미한 것으로 알려져 있습니다. 이때도 인텔은 아크 A770/750의 가격 대비 그래픽 성능이 지포스 RTX 3060보다 뛰어나다고 주장했지만, 시장에서 반응은 좋지 않았습니다. 게임 호환성이 떨어져 프레임이 안정적으로 유지되지 못하거나 오래된 게임에서 성능이 제대로 나오지 않았기 때문입니다. 더구나 전기도 많이 먹었습니다. 이를 의식한 탓인지 2세대인 아크 B580은 미세공정을 개선하면서도 트랜지스터 숫자를 줄이고, 미세 공정과 아키텍처를 개선해서 아크 A750보다 전력 소모는 줄이고 성능은 24% 정도 개선했습니다. 가격도 B580이 249달러, B570이 219달러로 출시가 기준 RTX 4060보다 저렴합니다. 순수 연산 능력은 FP32 기준 14.6TFLOPS로 RTX 4060과 거의 비슷합니다. 다만 5㎚ 공정으로 제조한 B580의 전력 소모는 TSMC의 4㎚ 공정을 사용한 RTX 4060보다 훨씬 많은 편입니다. 게임에서의 실제 체감 성능은 여전히 열세로 예상되는 상황에서 상대적으로 구형인 TSMC의 5㎚ 공정을 선택해 가격을 낮춘 전략이 효과를 볼 수 있을지 주목됩니다. 현재 AI 하드웨어 분야의 절대 강자인 엔비디아에 대응하기 위해 인텔은 AI 성능에도 공을 들였습니다. AI 게임 이미지 품질 향상 및 성능 향상 기능인 XeSS 역시 2세대로 업그레이드되면서 엔비디아의 게임 AI 성능 향상 기술인 DLSS를 추격하고 있습니다. 인텔은 DLSS처럼 해상도를 높이는 XeSS SR(Super Resolution) 기능과 프레임을 높이는 XeSS FG(Frame Generation)를 통해 게임 성능을 2.8배에서 3.9배까지 올릴 수 있다고 주장했습니다. 추가로 더 흥미로운 기능은 게임 반응 속도를 높이는 XeSS LL(Low Latency)으로 반응 속도가 중요한 FPS 게임 등에서 유용한 기능으로 보입니다. 아크 B580의 AI 엔진인 XMX AI 엔진은 게임에서만 활용되는 것이 아닙니다. 인텔은 생성형 AI에도 XMX AI 엔진을 사용할 수 있다고 강조했습니다. AI 성능은 FP 16 기준 117TFLOPS이고 INT8 기준으로 233TOPS로 수치상으로 보면 한 단계 상위 GPU인 RTX 4070과 비슷한 수준입니다. 소비자들은 아크 B580을 이용해 자신의 컴퓨터로 직접 생성형 AI를 통해 이미지, 영상, 언어 등을 생성할 수 있습니다. 물론 게임과 마찬가지로 AI 생태계 역시 엔비디아 GPU에 최적화되어 있어 실제로 주장한 수준으로 성능이 나올지는 의문이지만, 게임용 그래픽 카드 시장에서 엔비디아의 독점이 매우 강해 파고들기 쉽지 않은 만큼 AI 연산 목적으로 틈새시장을 노리는 것도 합리적인 선택일지 모릅니다. 다만 이런 노력에도 불구하고 아크 B580/570의 판매량이 신통치 않다면 그래픽 카드 시장에서 인텔의 미래는 상당히 불투명해질 것으로 보입니다. 최근 인텔은 대규모 해고 계획과 비용 절감 계획을 발표하고 실행에 옮기는 중입니다. 그런 와중에 적자가 나는 그래픽 카드 사업을 계속 유지할 여력이 될지 의구심이 커지고 있습니다. 인텔 아크 B580/570의 성패에 인텔 그래픽 카드 사업의 생사가 걸려있다고 해도 과언이 아닌 상황에서 출시 후 시장의 반응이 궁금합니다.
  • 마지막 그래픽 카드? 기사회생 신호탄?… 인텔, 아크 B580 배틀메이지 공개 [TECH+]

    마지막 그래픽 카드? 기사회생 신호탄?… 인텔, 아크 B580 배틀메이지 공개 [TECH+]

    현재 인텔은 창립 이후 반세기 만에 최대 위기를 맞이하고 있습니다. 2021년 인텔로 복귀하며 야심 찬 IDM 2.0 계획을 발표했던 팻 겔싱어 인텔 최고경영자(CEO)는 역대급 손실과 함께 인텔을 떠났고 그가 추진한 많은 사업들은 진행 여부가 불투명해진 상황입니다. 현재 인텔은 본업인 CPU 사업에서 경쟁력을 잃었고 신규로 진입한 인공지능(AI)나 파운드리, 그래픽 카드 사업도 부진한 상황입니다. 이런 상황에서 인텔은 2세대 독립 그래픽 카드인 인텔 아크 B500 시리즈를 공개했습니다. 코드네임 배틀메이지(Battlemage) GPU는 Xe 2 아키텍처를 적용한 GPU로 인텔 아크 B580과 B570 두 가지 제품으로 출시됐습니다. 두 제품 모두 BMG-G21 GPU를 이용한 것으로 B570는 B580에서 일부 유닛을 제외한 보급형 제품입니다. BMG-G21 GPU는 TSMC의 5㎚(나노미터) 공정으로 제조되었는데, 트랜지스터 집적도는 196억개이며 반도체 다이(die) 사이즈는 272㎟입니다. 반도체 집적도와 성능면에서 엔비디아의 보급형 그래픽 카드인 지포스 RTX 4060을 경쟁 상대로 설정한 것으로 보이는데, 인텔은 아크 B580의 게임 성능이 RTX 4060보다 10% 정도 빠르다고 주장합니다. 하지만 인텔의 1세대 아크 그래픽 카드는 판매량이 미미한 것으로 알려져 있습니다. 이때도 인텔은 아크 A770/750의 가격 대비 그래픽 성능이 지포스 RTX 3060보다 뛰어나다고 주장했지만, 시장에서 반응은 좋지 않았습니다. 게임 호환성이 떨어져 프레임이 안정적으로 유지되지 못하거나 오래된 게임에서 성능이 제대로 나오지 않았기 때문입니다. 더구나 전기도 많이 먹었습니다. 이를 의식한 탓인지 2세대인 아크 B580은 미세공정을 개선하면서도 트랜지스터 숫자를 줄이고, 미세 공정과 아키텍처를 개선해서 아크 A750보다 전력 소모는 줄이고 성능은 24% 정도 개선했습니다. 가격도 B580이 249달러, B570이 219달러로 출시가 기준 RTX 4060보다 저렴합니다. 순수 연산 능력은 FP32 기준 14.6TFLOPS로 RTX 4060과 거의 비슷합니다. 다만 5㎚ 공정으로 제조한 B580의 전력 소모는 TSMC의 4㎚ 공정을 사용한 RTX 4060보다 훨씬 많은 편입니다. 게임에서의 실제 체감 성능은 여전히 열세로 예상되는 상황에서 상대적으로 구형인 TSMC의 5㎚ 공정을 선택해 가격을 낮춘 전략이 효과를 볼 수 있을지 주목됩니다. 현재 AI 하드웨어 분야의 절대 강자인 엔비디아에 대응하기 위해 인텔은 AI 성능에도 공을 들였습니다. AI 게임 이미지 품질 향상 및 성능 향상 기능인 XeSS 역시 2세대로 업그레이드되면서 엔비디아의 게임 AI 성능 향상 기술인 DLSS를 추격하고 있습니다. 인텔은 DLSS처럼 해상도를 높이는 XeSS SR(Super Resolution) 기능과 프레임을 높이는 XeSS FG(Frame Generation)를 통해 게임 성능을 2.8배에서 3.9배까지 올릴 수 있다고 주장했습니다. 추가로 더 흥미로운 기능은 게임 반응 속도를 높이는 XeSS LL(Low Latency)으로 반응 속도가 중요한 FPS 게임 등에서 유용한 기능으로 보입니다. 아크 B580의 AI 엔진인 XMX AI 엔진은 게임에서만 활용되는 것이 아닙니다. 인텔은 생성형 AI에도 XMX AI 엔진을 사용할 수 있다고 강조했습니다. AI 성능은 FP 16 기준 117TFLOPS이고 INT8 기준으로 233TOPS로 수치상으로 보면 한 단계 상위 GPU인 RTX 4070과 비슷한 수준입니다. 소비자들은 아크 B580을 이용해 자신의 컴퓨터로 직접 생성형 AI를 통해 이미지, 영상, 언어 등을 생성할 수 있습니다. 물론 게임과 마찬가지로 AI 생태계 역시 엔비디아 GPU에 최적화되어 있어 실제로 주장한 수준으로 성능이 나올지는 의문이지만, 게임용 그래픽 카드 시장에서 엔비디아의 독점이 매우 강해 파고들기 쉽지 않은 만큼 AI 연산 목적으로 틈새시장을 노리는 것도 합리적인 선택일지 모릅니다. 다만 이런 노력에도 불구하고 아크 B580/570의 판매량이 신통치 않다면 그래픽 카드 시장에서 인텔의 미래는 상당히 불투명해질 것으로 보입니다. 최근 인텔은 대규모 해고 계획과 비용 절감 계획을 발표하고 실행에 옮기는 중입니다. 그런 와중에 적자가 나는 그래픽 카드 사업을 계속 유지할 여력이 될지 의구심이 커지고 있습니다. 인텔 아크 B580/570의 성패에 인텔 그래픽 카드 사업의 생사가 걸려있다고 해도 과언이 아닌 상황에서 출시 후 시장의 반응이 궁금합니다.
  • 모든 것을 바꿨다…인텔 메테오 레이크에서 보여준 타일 아키텍처의 혁신[고든 정의 TECH+]

    모든 것을 바꿨다…인텔 메테오 레이크에서 보여준 타일 아키텍처의 혁신[고든 정의 TECH+]

    최근 인텔은 14세대 코어 프로세서인 메테오 레이크의 세부 내용을 공개했습니다. 메테오 레이크는 CPU 코어가 모여 있는 CPU 타일, GPU가 있는 GPU 타일, 기타 기능이 집약된 SoC 타일, 입출력 기능을 담당하는 I/O 타일 네 가지가 베이스 타일 위에 올려진 독특한 구조로 인텔이 10세대 레이크필드에서 시험한 포베로스 (Foveros) 기술을 주력 CPU까지 확장한 첫 번째 제품입니다.  타일 방식의 장점은 각각의 다이의 크기를 줄여 생산 비용을 절감하고 최신 미세 공정이 필요하지 않은 경우에는 좀 더 저렴한 공정을 적용해 비용은 절감하고 성능은 높이는 데 있습니다. 그리고 생산에서도 상당한 유연성을 발휘할 수 있습니다.  만약 메테오 레이크 전체를 최신 미세 공정인 인텔 4 공정으로 제조한다면 상당한 비용이 들어가는 것은 물론 충분한 수량을 공급하기 어렵습니다. 인텔은 빠르게 인텔 3, 20A, 18A 같은 다음 세대 미세 공정으로 진입할 계획이기 때문에 인텔 4 공정 팹을 대규모로 늘릴 수도 없습니다. 그런 상황에서 CPU 타일만 인텔 4 공정으로 제조하고 나머지는 TSMC에서 외주를 주는 방식으로 선회한 것입니다. 물론 TSMC 5nm, 6nm도 상당히 미세 공정이지만, 4nm, 3nm 같은 더 최신 미세 공정이 아니기 때문에 상대적으로 수급이 쉽고 가격 협상에서도 유리합니다.  이런 내용은 이전부터 알려진 것이지만, 최근 인텔은 지금까지 공개하지 않았던 놀라운 이야기를 공개했습니다. 바로 미스터리한 SoC 타일의 정체입니다. TSMC의 6nm 공정이 적용한 SoC 타일은 면적이 오히려 CPU나 GPU 타일보다 커서 상당한 양의 트랜지스터가 집적된 것으로 보이지만, 도대체 뭐가 들어 있는지는 잘 몰랐습니다. 인텔에 의하면 이 안에는 저전력 (LP) 고효율 (E) 코어와 인공지능 연산을 담당하는 NPU, 그리고 GPU에서 독립한 미디어 엔진과 디스플레이 엔진이 숨어 있었습니다.  1. CPU밖의 CPU, LP E코어 컴퓨터의 두뇌는 CPU입니다. 최근에는 프로세서가 복잡해지면서 CPU 이외의 많은 메모리, GPU, 기타 입출력 담당 회로 등 여러 가지가 포함되어 있기는 하지만, CPU는 컴퓨터 메인보드의 가운데 보다 약간 위에 있는 상석을 차지하고 있는 게 일반적입니다. 오디오 칩이나 다른 기능을 관리하는 칩셋은 메인보드 여기저기에 흩어져 있습니다. 하지만 메테오 레이크는 CPU를 CPU 타일 밖에 배치하는 독특한 구성을 선택했습니다. 인텔 CPU 가운데서 첫 번째 시도일 뿐 아니라 사실 지금까지 발표된 CPU 가운데서 비슷한 사례를 찾을 수 없는 독특한 구성입니다. 이 구성의 장점은 빠른 속도로 움직일 필요가 없는 저전력 코어에 비싼 최신 미세 공정을 적용하지 않아도 된다는 것입니다. 메테오 레이크는 고성능 코어 (P 코어)인 레드우드 코브와 고효율 코어 (E 코어)인 크레스트몬트 코어로 되어 있습니다. 여기에 SoC 타일에 있는 저전력 (LP) E 코어까지 합쳐 세 가지 형태의 코어를 지닌 최초의 x86 CPU입니다. 덕분에 노트북에서 초저전력 모드, 저전력 모드, 고성능 모드 등 상황에 맞춰 더 유연한 전력 및 성능 관리할 수 있습니다.  2. 인공지능 가속기를 탑재한 첫 CPU SoC 타일에 들어 있는 두 번째 깜짝 선물은 바로 NPU입니다. 컴퓨터용 CPU에 인공지능 가속기를 탑재한 것은 애플이 최초입니다. 애플의 M 시리즈 칩셋에는 A 시리즈에서 사용한 뉴럴 엔진이 포함되어 각종 인공지능 연산을 더 빠르게 수행할 수 있습니다. 메테오 레이크에 처음 탑재되는 NPU는 CPU 단독으로 사용했을 때보다 8배나 빠르게 인공지능 연산을 수행할 수 있으며 CPU, GPU와 독립적으로 시행되기 때문에 부하를 덜어줄 수 있습니다.  다만 NPU가 윈도우 환경에서 어떤 도움이 될지는 아직 미지수입니다. 우선 생각할 수 있는 건 인공지능을 통해 게임 성능 향상인데, 인텔의 XeSS는 엔비디아의 DLSS보다 적용되는 게임도 적고 기술적으로도 아직 미숙한 상태입니다. 인텔은 윈도우 스튜디오 등 몇몇 애플리케이션에서 이를 응용할 수 있다고 이야기하고 있으나 실제 소비자들이 체감할 수 있는 부분이 얼마나 될지는 두고 봐야 알 수 있을 것 같습니다.  3. GPU와 독립한 Xe 디스플레이, Xe 미디어 엔진 SoC의 타일의 큰 면적 중 일부는 본래 GPU에 포함되었던 Xe 디스플레이, Xe 미디어 엔진에 할당됐습니다. Xe 디스플레이 엔진은 최대 8K, 60프레임 출력과 HDMI 2.1 디스플레이포트 2.1등의 규격을 담당합니다. 만약 4K 모니터라면 최대 4개까지 지원이 가능합니다. Xe 미디어 엔진은 8K 60프레임/10비트 HDR 영상 인코딩, 디코딩 지원, VP9, AVC, HEVC, AV1 같은 최신 코덱을 지원합니다. 하지만 사실 이것만으로는 소비자가 체감할 변화가 있다고 보기는 어렵습니다. 진짜 중요한 변화는 사실 5nm 공정으로 만든 GPU 타일에 있습니다. GPU에서 빠르게 움직일 필요가 없는 인공지능 가속기와 디스플레이 출력, 동영상 처리 기능을 빼서 SoC 타일에 넣었기 때문에 GPU 성능이 한층 강화됐습니다.  메테오 레이크의 내장 GPU인 Xe-LPG는 모두 8개의 Xe 코어를 탑재하고 있으며 각각의 코어는 16개의 256비트 벡터 엔진을 탑재해 전 세대보다 33%가 늘어났습니다. 별도의 GPU 타일을 이용하고 최신 미세 공정을 적용한 만큼 성능 향상은 33% 이상일 가능성이 높습니다.  종합하면 메테오 레이크는 인텔의 CPU 설계 사상이 완전히 달라졌다는 사실을 보여주고 있습니다. CPU, GPU, NPU, 칩셋 등 여러 가지 구성 요소를 기능에 따라 묶은 것이 아니라 성능과 클럭에 따라 묶어서 최적의 성능을 내면서 비용은 절감하는 방식을 선택한 것입니다. 타일 아키텍처를 선택하면서 제조 방식만 바꾼 게 아니라 설계 사상과 구조도 거기에 맞게 뜯어고친 셈입니다.  다만 소비자 입장에서는 설계 사상이 무엇이고 어떤 타일을 사용했는가 보다는 성능과 가격이 더 큰 관심사일 수밖에 없습니다. 메테오 레이크는 올해 말 출시 예정으로 이를 탑재한 노트북이 연말과 연초에 대거 출시될 것으로 보입니다. 그때가 되면 구체적으로 뭐가 좋아졌는지 확실하게 알게 될 것입니다.
  • [고든 정의 TECH+] 인공지능 게임 성능 향상 기술의 화룡점정 – 엔비디아 DLSS 3.5 공개

    [고든 정의 TECH+] 인공지능 게임 성능 향상 기술의 화룡점정 – 엔비디아 DLSS 3.5 공개

    최근 인공지능 하드웨어의 핵심인 GPU 시장을 거머쥔 엔비디아에 대한 관심이 뜨겁습니다. 엔비디아는 반도체 업계 최초로 시총 1조 달러를 달성한 후 최근 계속 어닝 서프라이즈를 기록하면서 승승장구하고 있습니다. 그런데 사실 인공지능 이전에 GPU는 본래 게임이 주목적이었습니다. 전문 그래픽 작업을 위한 쿼드로 같은 별도의 시장이 있기는 했지만, 엔비디아의 젠슨 황 CEO가 연산 목적의 GPGPU와 CUDA에 힘을 주기 전까지 엔비디아는 게임 하드웨어 회사라고 해도 과언이 아니었습니다.  그렇기 때문에 엔비디아가 게임 성능 향상을 위해 인공지능을 적극적으로 활용한다는 사실은 지극히 당연해 보입니다. 엔비디아는 2018년 RTX 2000 시리즈를 공개할 때 GPU와 통합된 인공지능 연산 유닛인 텐서 코어를 이용한 DLSS (Deep Learning Super-Sampling, 딥 러닝 슈퍼 샘플링)을 대대적으로 홍보했습니다.  인공지능을 이용해서 저해상도 이미지를 고해상도 이미지처럼 업스케일링 하는 기술은 이미 당시에도 개발되어 있었습니다. DLSS는 게임에서 인공지능으로 고해상도 이미지를 학습한 다음 실제로는 저해상도로 그래픽을 출력한 후 여기에 인공지능 학습으로 추론한 고해상도 이미지를 추가하는 방식으로 이뤄집니다. 영상이나 사진의 인공지능 이미지 품질 향상 기능을 게임에서 활용한 것입니다.  이 작업은 GPU 연산 유닛이 아니라 텐서 코어라는 별도의 연산 유닛에서 이뤄지기 때문에 GPU에 부하가 없고 저해상도로 이미지를 출력하므로 게임 화면의 초당 프레임을 높일 수 있습니다. 예를 들어 본래는 4K 해상도에서 초당 20 프레임도 안 되는 답답한 화면이 나오는데 DLSS를 적용하면 이보다 해상도가 25%인 풀HD 영상으로 60 프레임으로 출력한 후 마치 4K 해상도처럼 보이게 할 수 있습니다.  하지만 실제로 DLSS는 1.0 버전까지 불안정한 기술이었고 지원하는 게임도 제한적이었습니다. 일부 지원하는 게임에서도 이미지 품질 향상 기술인 안티 앨리어싱과 충돌하거나 이미지가 뭉개지거나 깨지는 현상이 나타났습니다. 그러다가 DLSS 2.0에서 보다 쓸만한 기술이 되어 이미지 품질이 상당히 높아졌습니다. 저해상도에서 4K 고해상도 이미지를 추론하는 DLSS 슈퍼 레졸루션 (SR, Super Resolution) 기능이 RTX 3000 그래픽 카드에서 지원하는 DLSS 2.0에서 어느 정도 완성이 된 것입니다. 하지만 엔비디아는 여기서 한 가지 더 트릭을 생각해 냈습니다.  RTX 4000 시리즈와 함께 공개된 DLSS 3.0은 프레임 생성 (FG, Frame Generation)이라는 신기술을 도입했는데, 이는 인공지능으로 각 영상 프레임 간의 중간 이미지를 넣어 더 부드러운 움직임과 화면 전환을 구현한 것입니다. 예를 들어 30 초당 화면이 30번 바뀌는 영상 사이사이에 인공지능으로 만든 중간 화면을 넣어 초당 60회 화면이 바뀌면 인간의 눈으로 봤을 때 영상이 훨씬 부드러워 보입니다.  여기에 더해 엔비디아는 최근 게임스컴 2023에서 DLSS 3.0을 더 개선한 DLSS 3.5를 공개했습니다. DLSS 3.5의 핵심은 GPU의 자원을 덜 소모하면서 현실적인 광원 효과를 보여주는 광선 재구성 (RR, Ray Reconstruction) 기술입니다.  사물이나 환경이 진짜처럼 보이기 위해서는 빛에 따른 반사나 그림자, 광원에 따른 명암 등이 실제처럼 표현되어야 합니다. 엔비디아의 RTX GPU들은 실시간 레이 트레이싱을 지원해 게임에서 현실적인 사물의 질감과 주변 환경을 보여줍니다. 하지만 이는 엄청난 GPU 성능을 요구해 게임 프레임을 떨어뜨리는 원인이었습니다.  DLSS는 광선 효과의 인공지능 처리를 위해서 과거엔 수작업으로 처리하는 노이즈 제거 (Denoiser) 방식을 사용했습니다. 하지만 이 방법은 일부 픽셀을 잃어버려 이미지가 뭉개지거나 반대로 존재하는 사물이 나타나는 고스팅 현상을 일으킬 수 있었습니다. 광선 재구성 기술은 레이 트레이싱을 완벽히 보완하는 인공지능 이미지 품질 향상 기술로 게임 프레임을 희생시키지 않으면서 고품질의 레이 트레이싱 영상을 실시간으로 보여줄 수 있습니다.  엔비디아는 사이버펑크 2077을 기준으로 DLSS를 적용하지 않았을 때, DLSS 슈퍼 레졸루션 (SR) 적용, DLSS 슈펴 레졸루션 (SR) + 프레임 생성 (FG), DLSS 슈펴 레졸루션 (SR) + 프레임 생성 (FG) + 광선 재구성 (RR) 기능을 적용한 결과물을 차례로 보여줬습니다. 그 결과 본래 초당 20프레임에 불과한 영상이 5배가 넘는 초당 108프레임으로 증가하고 이미지 품질도 개선되는 결과를 보여줬습니다. 레이 트레이싱까지 확장한 DLSS 3.5를 인공지능 게임 성능 향상의 화룡점정이라고 불러도 손색이 없는 이유입니다.  물론 DLSS 3.5를 지원하는 게임은 초기엔 사이버펑크 2077를 포함해 몇 개 없습니다. 하지만 대부분의 게이밍 그래픽 카드가 엔비디아 제품인 점을 생각하면 DLSS이 표준으로 보급되는 것은 시간문제입니다.  DLSS 3.5 지원 게임이 늘어나면 인공지능 적용 전 게임 성능에서도 엔비디아의 적수가 되기 어려운 AMD의 라데온이나 인텔 아크와의 성능 차이는 더 벌어질 가능성이 높아졌습니다. 하지만 이렇게 한 회사가 시장을 장악하는 것은 사실 소비자에게 좋지 못한 결과를 가져옵니다. 독점 기업은 대부분 가격을 인상하기 때문입니다. 실제 엔비디아 GPU의 가격은 인공지능 및 데이터 센터 부분만이 아니라 게이밍 부분도 치솟고 있습니다. 두 회사가 DLSS를 견제할 비장의 무기를 선보여야 하는 이유입니다. 
  • [고든 정의 TECH+] 맛있어 보이지만, 너무 비싼 그림의 떡…차세대 그래픽 카드 RTX 4090/4080 공개

    [고든 정의 TECH+] 맛있어 보이지만, 너무 비싼 그림의 떡…차세대 그래픽 카드 RTX 4090/4080 공개

    엔비디아가 GTC 2022 행사를 통해 차세대 그래픽 카드(코드 네임 에이다 러브레이스 Ada Lovelace)인 RTX 4090과 RTX 4080 16GB/12GB를 공개했습니다. 이번 신제품 공개는 가상화폐 채굴로 인해 RTX 3000 시리즈 그래픽 카드를 제때 구매하지 못한 소비자들이 기다려왔던 행사입니다. 지난 몇 년간 가상화폐 채굴 수요로 그래픽 카드 가격이 폭등하자 정작 주 수요층인 PC 게임 유저들은 기존의 그래픽 카드를 사용할 수밖에 없었습니다. 최근 가상화폐 가격 폭락으로 그래픽 카드 가격이 빠른 속도로 정상화되기는 했지만, 기왕 기다린 참에 차라리 새 제품을 사려는 대기 수요가 많았습니다.  오랜 기다림 끝에 등장한 RTX 4000 시리즈는 강력한 성능과 새로운 기능으로 무장했습니다. 가장 고성능 칩인 AD102를 쓰는 RTX4090의 경우 이전 세대인 RTX 3090Ti (GA102)보다 1.5배 정도 많은 16,384개의 스트림 프로세서(쿠다 코어)를 지니고 있으며 연산 능력도 FP32 기준 82.6테라플롭스(TFLOPS)로 두 배가 넘는 수준입니다. 스트림 프로세서 증가 대비 연산 능력 증가폭이 더 큰 이유는 부스트 클럭이 1.8GHz에서 2.5GHz로 크게 높아진 것이 이유로 생각됩니다.  하지만 AD102 칩이 GA102와 비교해서 480억 개나 늘어난 760억 개의 트랜지스터를 집적했다는 점을 생각하면 늘어난 부분 중 상당 부분이 스트림 프로세서가 아니라는 점을 유추할 수 있습니다. 구체적인 구조를 공개하지 않아 현재로는 추측에 의존할 수밖에 없지만, 늘어난 트랜지스터의 상당 부분은 L2 캐시 메모리와 RT 코어, 텐서 코어에 할당되었을 것으로 생각됩니다.  RT 코어는 실시간 레이 트레이싱 (RT) 연산을 처리하는 부분으로 사실적인 광원 처리를 통해 사물이 진짜처럼 보이게 만듭니다. RTX 4090의 RT 연산 능력은 200테라플롭스로 전 세대와 비교해 세 배 정도 강력합니다. 3세대 RT 코어의 성능이 대폭 향상된 점으로 볼 때 이 부분이 상당히 커졌다는 점을 알 수 있습니다.  인공지능 연산을 처리하는 텐서 코어 역시 마찬가지입니다. RTX 4090의 텐서 연산 능력은 1,400테라플롭스로 전 세대의 4배가 넘는 수준입니다. 역시 텐서 코어의 크기가 상당히 커졌다는 점을 유추할 수 있는데, 덕분에 인공지능을 이용한 이미지 품질 향상 기능인 DLSS이 3세대로 진화하면서 성능이 향상됐습니다. 엔비디아의 엔지니어들은 그래픽 쉐이더 연산 능력, 실시간 레이트레이싱 (RT) 연산 능력, 인공지능 연산 능력만 대폭 향상된 것이 아니라 이들을 유기적으로 연계해서 최종 결과물을 좋게 하는데도 심혈을 기울였습니다. 이제 게임 및 그래픽 개발자들은 RT 뉴럴 렌더링을 통해 쉐이더, RT, 텐서 코어를 프로그래밍 하고 AI 모델에 따라 연산할 수 있게 됐습니다.  또 한 가지 신기한 기능은 오래전 게임의 이미지 품질을 인공지능이 스스로 개선하고 RTX 효과를 입히는 RTX 리믹스입니다. 출시된 지 20년 된 게임인 엘더스크롤 3 모로윈드는 출시 당시에는 훌륭했지만, 지금 보면 매우 낮은 그래픽 품질을 보여줍니다. 여기에 RTX 리믹스를 적용하면 인공지능을 이용해 고해상도 텍스처와 최신 광원효과를 입혀 마치 최신 게임처럼 보이게 만들 수 있습니다. 이외에도 현존하는 그래픽 카드 중 최강의 인공지능 연산 능력을 이용해 여러 가지 응용이 가능할 것으로 기대됩니다.  하지만 막상 공개된 가격은 많은 사람을 실망시켰습니다. 가장 상위 제품인 RTX 4090이 1,599달러인 점은 이해할 수 있지만, RTX 4080 16GB와 12GB의 가격이 각각 1,199달러와 899달러로 책정된 것은 과한 가격 인상이라는 것입니다. 참고로 RTX 3090은 1,499달러 RTX 3080은 699달러, RTX 3070은 499달러의 가격으로 출시됐습니다. 나중에 채굴 수요로 가격이 폭등했던 것이지 처음에는 합리적인 가격이었던 것입니다.  더구나 AD103과 AD104라는 서로 다른 칩을 사용한 제품을 RTX 4080 16GB와 RTX 4080 12GB라는 이름으로 출시한 배경 역시 석연치 않습니다. 본래는 RTX 4080과 RTX 4070이었는데 가격을 많이 올리면서 더 상위 제품처럼 보이기 위해 이런 무리한 명칭을 붙이지 않았나 하는 느낌이 들 정도입니다.  이렇게 가격을 올린 데다 국내에서는 환율로 인해 가격이 더 크게 올랐습니다. RTX 4090의 가격은 263만원, RTX 4080 16GB는 192만원, RTX 4080 12GB는 140만원으로 게임 목적으로만 구매하기에는 상당히 부담스러운 가격입니다. 그나마 RTX 4080은 나중에 출시하고 RTX 4090이 먼저 등장합니다. RTX 4070/4060/4050 등 중급형 모델 출시 계획은 아예 발표된 게 없습니다.  이런 고가 정책은 엔비디아가 그래픽 카드 시장을 거의 독점하다시피 해 다른 대안이 없는 것이 중요한 배경으로 풀이됩니다. 사실상 유일한 경쟁자인 AMD 라데온 그래픽 카드는 시장 점유율이 낮고 인텔 아크 그래픽 카드는 이제 막 시장에 진입한 상태로 현재까지는 시장에 별 영향력이 없습니다. 따라서 최신 고성능 그래픽 카드를 구입하려면 값비싼 RTX 4000 시리즈나 구형이 되어 버린 RTX 3000 시리즈 중 하나를 택해야 합니다.  하지만 이렇게 소비자를 포용하지 못하는 가격 정책은 장기적으로 독이 될 수 있습니다. 아무리 훌륭한 그래픽을 보여준다고 해도 그래픽 카드는 생필품이 아니기 때문에 비싸더라도 어쩔 수 없이 구매할 소비자가 많지 않습니다. 상당수는 더 저렴한 콘솔 게임기나 스트리밍 서비스에 관심을 돌릴 수 있습니다. 물론 TSMC의 4N 같은 최신 미세 공정과 대용량 GDDR6X 메모리를 적용한 만큼 가격이 저렴할 순 없지만, 고가 제품이 있다면 일반 소비자를 위한 보급형 제품도 있는 것이 순리일 것입니다. 엔비디아가 가까운 미래에 합리적인 가격의 중급 모델을 보여주기를 기대합니다. 
  • [고든 정의 TECH+] 인텔 그래픽 카드 ‘아크’ 출격...엔비디아 잡을까

    [고든 정의 TECH+] 인텔 그래픽 카드 ‘아크’ 출격...엔비디아 잡을까

    인텔은 CPU 제조사로 가장 잘 알려져 있고 대부분의 매출이 이와 관련된 것이지만, 사실 생각보다 다양한 사업에 진출했었습니다. 하지만 잘나가는 기업이라고 해서 모든 사업이 다 잘 될 순 없어 결국 사업을 금방 접었기 때문에 잘 알려지지 않은 것입니다.  대표적인 사례가 바로 인텔 그래픽 카드입니다. 인텔 최초의 독립 그래픽 칩인 i740은 1990년대 후반 보급형 시장에서 그럭저럭 인기를 끌었으나 엔비디아 같은 경쟁자에 밀려 시장에서 설 자리를 잃게 됩니다. 결국 인텔은 독립 그래픽 카드 시장을 포기하고 이후에는 내장 그래픽으로 만족하게 됩니다. GPU 시장이 성장하고 있었지만, 아직 CPU 시장만큼 크지 않았고 무엇보다 CPU 시장처럼 인텔이 독점하기 힘들어 수익성이 좋지 않을 것으로 생각했기 때문입니다.  하지만 2010년대에 중반 이후 상황이 바뀌게 됩니다. GPU는 게임만 하는 도구가 아니라 인공지능 연산에 없어서는 안 될 핵심 인프라로 거듭나며 수요가 폭발하게 됩니다. 이 분야 1위인 엔비디아의 가치는 그야말로 폭등해 시가 총액이 7000억 달러에 도달했습니다. 반면 인텔의 시가 총액은 2000억 달러 수준입니다. 반도체 업계 1위인 인텔의 가치가 엔비디아의 1/3도 안 되는 수준으로 떨어진 것입니다.  이런 상황에서 인텔은 지난 몇 년간 자체 그래픽 카드를 만들기 위해 와신상담 칼을 갈아왔습니다. 그리고 이제 인텔 아크 알케미스트 (Intel Arc Alchemist) 그래픽 카드를 통해 첫 결과물을 내놓을 예정입니다. 인텔은 노트북 그래픽 카드인 인텔 아크 A 시리즈에 대한 상세한 정보를 공개했습니다. 인텔 아크 A 시리즈는 ACM-G11와 ACM-G10이라는 두 개의 칩을 이용해 인텔 아크 3 2종, 아크 5 1종, 아크 7 2종, 총 5종의 제품 (A350M, A370M, A550M, A730M, A770M)으로 등장할 예정입니다. 이중에서 올해 4월 먼저 등장할 제품은 소형 GPU인 ACM-G11 기반의 아크 3 A350M과 A370M입니다. 이 제품들은 보급형 노트북 그래픽 카드로 6개 혹은 8개의 Xe 코어를 탑재하고 있습니다. 각각의 코어는 최대 16개의 XVE 벡터 엔진과 XMX 메트릭스 엔진을 포함하고 있는데, 전자가 그래픽 연산을 담당하고 후자는 인공지능 연산을 담당합니다. 초기 제품들은 엔비디아의 지포스 MX 라인업과 경쟁할 예정으로 성능은 내장 그래픽보다 조금 나은 수준이 될 것으로 보입니다. 중급 및 고급형 제품인 아크 5/7 라인업 제품들은 16, 24, 32개의 Xe 코어를 지니고 있습니다. 최상위 제품은 A770M은 32개의 Xe 코어와 512개의 XVE 벡터 엔진, 512개의 XMX 메트릭스 엔진, 32개의 레이 트레이싱 유닛을 지니고 있으며 16GB의 대용량 GDDR6 메모리를 탑재해 매우 높은 성능이 예상됩니다. 다만 전력 소모량도 120-150W에 달해 엄청난 발열량을 감당할 수 있는 고성능 게이밍 노트북에 탑재될 것으로 보입니다.물론 그래픽 카드 사장에 오래전 진출한 엔비디아나 AMD는 기본 연산 능력은 물론이고 게임에서 지원하는 여러 가지 이미지 품질 향상이나 동영상 녹화 등 부가기능을 제공합니다. 인텔 역시 이런 점을 인식해 올해 첫 출시하는 아크 그래픽 카드에 몇 가지 신기술을 제공합니다. 그중 하나가 엔비디아의 DLSS 같은 업스케일링 기술인 XeSS(Xe Super Sampling)입니다. 인텔은 개발 중인 게임인 돌맨 (Dolmen)에서 상당한 수준의 이미지 품질 데모를 보여줬지만, DLSS처럼 많은 게임에서 지원 가능한지 여부가 중요할 것으로 보입니다.인텔은 동영상 녹화 및 재생 부분에도 힘을 기울였습니다. 영상처리를 담당하는 Xe 미디어 엔진은 8K@60 12비트 HDR 영상 디코딩이 가능합니다. 8K HDR 영상 인코딩 역시 지원합니다. 게임 방송을 하는 경우 업계 최초로 AV1 포맷 하드웨어 가속으로 실시간 고품질 영상을 전송할 수 있다는 것이 인텔의 설명입니다.  마지막으로 엔비디아나 AMD처럼 그래픽 카드의 세세한 설정이 가능한 아크 컨트롤 기능 역시 제공합니다.  인텔은 지난 몇 년간 아크 그래픽 카드를 위해 많은 것을 준비한 것으로 보입니다. 하지만 상대방은 그보다 더 많은 것을 지니고 있다는 것이 문제입니다. 올해 새로 출발하는 인텔 아크가 지포스와 라데온의 틈바구니 사이에서 자신만의 입지를 다질 수 있을지 결과가 주목됩니다.
위로