찾아보고 싶은 뉴스가 있다면, 검색
검색
최근검색어
  • 제로샷
    2026-10-06
    검색기록 지우기
  • 예방
    2026-10-06
    검색기록 지우기
  • 부족
    2026-10-06
    검색기록 지우기
  • 한센병
    2026-10-06
    검색기록 지우기
  • 대물림
    2026-10-06
    검색기록 지우기
저장된 검색어가 없습니다.
검색어 저장 기능이 꺼져 있습니다.
검색어 저장 끄기
전체삭제
총 4 건
  • LG 엑사원, 표·시계열 데이터 기반 산업 데이터 분석에서 구글·알리바바 제쳐

    LG 엑사원, 표·시계열 데이터 기반 산업 데이터 분석에서 구글·알리바바 제쳐

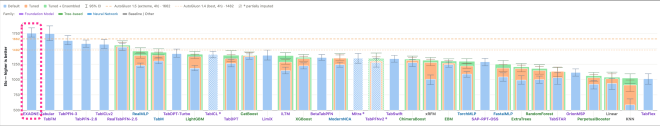
    LG AI연구원이 개발한 산업 특화 인공지능(AI) 파운데이션 모델이 산업 데이터 예측 분야에서 구글과 알리바바 등 글로벌 빅테크를 제치고 세계 최고 수준의 성능을 입증했다. LG는 올해 하반기 제조와 금융, 바이오·헬스케어 분야에서 기술 검증(PoC)을 진행한 뒤 사업화에 속도를 낸다는 계획이다. LG AI연구원은 표 데이터를 분석·예측하는 ‘엑사원 태뷸러’와 시계열 데이터를 기반으로 미래를 예측하는 ‘엑사원 포캐스트(Forecast)’가 글로벌 AI 성능 평가(리더보드)에서 각각 세계 최고 수준의 성능을 기록했다고 7일 밝혔다. 산업 데이터 예측 성능을 평가하는 글로벌 리더보드는 화학, 의료, 금융, 제조 등 실제 산업 현장에서 생성되는 데이터를 기반으로 AI의 예측 능력을 검증하는 지표다. 엑사원 태뷸러는 다양한 산업에서 활용되는 표 형태의 정형 데이터를 분석하는 AI 모델이다. 기존 범용 거대언어모델(LLM)이 표를 텍스트로 변환해 처리하는 것과 달리 행과 열의 구조, 데이터 간 관계를 직접 이해하는 것이 특징이다. 이 모델은 글로벌 리더보드인 ‘탭아레나(TabArena)’의 범주형 데이터 예측 부문에서 종합 1위를 차지했다. 평가 점수(ELO)는 1760점으로, 구글이 최근 공개한 ‘탭FM(TabFM)’의 1749점을 앞섰다. 엑사원 포캐스트도 시계열 데이터 예측 성능을 평가하는 글로벌 리더보드 ‘기프트-이밸(GIFT-Eval)’에서 구글과 알리바바 등을 제치고, 추가 학습 없이 새로운 분야의 데이터를 예측하는 ‘제로샷’ 부문 1위에 올랐다. 실제 업무 환경에서 AI가 스스로 데이터를 분석하고 예측하는 ‘에이전틱 AI’ 부문에서도 2위를 기록하며 산업 현장 적용 가능성을 입증했다. LG AI연구원은 올해 하반기 제조와 바이오·헬스케어, 금융 분야에서 PoC를 진행한 뒤 사업화를 본격 추진할 계획이다. 제조 분야에서는 배터리 품질 판정, 바이오·헬스케어에서는 질병 위험도 예측, 금융 분야에서는 연체·부도·이상거래 탐지 등에 활용할 수 있을 것으로 기대하고 있다. 엑사원 포캐스트는 이미 LG전자와 LG에너지솔루션의 제품 수요와 원자재 가격 예측에 활용되고 있다. 올해부터는 코스콤(KOSCOM), 런던증권거래소그룹(LSEG)과 협력해 한국과 미국 증시를 분석하는 AI 서비스도 제공 중이다. LG AI연구원은 산업 특화 AI 적용 범위도 확대하고 있다. 병리학 AI 모델 ‘엑사원 패스(Path)’를 기반으로 암 진단을 지원하는 에이전틱 AI를 개발 중이며, 시각 정보를 이해해 로봇을 제어하는 로봇 파운데이션 모델도 개발하고 있다. 임우형 LG AI연구원 공동연구원장은 “글로벌 빅테크의 관심이 범용 언어모델에서 실제 산업 현장의 문제를 해결하는 산업 특화 AI로 빠르게 이동하고 있다”며 “국내 제조업을 비롯한 다양한 산업 현장에서 축적한 데이터가 한국 AI의 차별화된 경쟁력이 될 수 있다는 점을 보여준 사례”라고 말했다.
  • 한기대 연구팀, 깊이 영상 노이즈에 강한 ‘사족보행 로봇 파쿠르 기술’ 개발

    한기대 연구팀, 깊이 영상 노이즈에 강한 ‘사족보행 로봇 파쿠르 기술’ 개발

    계단·단차 등 주변 지형 안정적 인식국제학술대회 ‘IROS 2026’ 논문 채택 한국기술교육대학교(총장 유길상)는 컴퓨터공학부 한연희 교수 연구팀이 ‘깊이 영상(depth image)의 센서 노이즈에 강인한 사족보행 로봇 파쿠르* 기술’ 개발에 성공했다고 23일 밝혔다. 깊이 영상은 카메라와 물체 사이 거리 정보를 픽셀 단위로 담은 영상이다. 로봇이 계단·틈·단차·장애물 등 주변 지형의 3차원 구조 파악에 활용된다. 연구 핵심은 실제 환경에서 발생하는 깊이 영상의 노이즈 영향을 줄여, 로봇이 장애물을 안정적으로 통과하게 하는 것이다. 기존 시각 기반 보행 로봇 연구는 학습 단계에서 ‘깨끗한 깊이 영상’을 가정하고, 실제 운용 시 발생하는 센서 노이즈는 후처리 필터에 의존해 왔다. 필터의 최적값은 조명·표면 재질·거리 분포에 따라 달라져, 환경이 바뀔 때마다 다시 조정해야 하는 한계점이 발생한다. 연구팀은 로봇이 주변 지형을 이해하고 예측하는 학습 단계에서부터 깊이 영상의 노이즈에 강하도록 설계된 인식 프레임워크 ‘DAWN(Denoising and Alignment in World models for Noise-robustness)’을 제안했다. DAWN은 노이즈가 섞인 영상과 깨끗한 영상을 함께 비교·학습하도록 설계해 실제 환경에서도 로봇이 불완전한 영상 정보에 흔들리지 않고 계단·단차 등 주변 지형을 안정적으로 인식할 수 있게 해 로봇의 환경 인식 및 제어 안정성을 높였다. 이 기법은 학습 단계에서만 적용되므로 실제 로봇이 동작할 때 추가 연산 비용이 발생하지 않는다. 환경에 따라 필터값을 일일이 조정하지 않아도 돼, 조명·표면 재질·거리 조건이 달라지는 다양한 실제 환경에 적용할 수 있다는 장점이 있다. 연구팀은 개발한 기술을 사족보행 로봇 Unitree Go1에 적용한 결과 높이 18cm 계단, 폭 70cm 틈, 높이 45cm 단차를 별도 추가 학습 없이 제로샷*으로 통과했다. 한연희 교수는 “이번 연구는 학생 연구자들이 문제 정의부터 실제 로봇 검증까지 전 과정을 주도해 거둔 성과라는 점에서 더욱 의미가 크다”고 강조했다. 이어 “불완전한 센서 데이터와 다양한 환경 변화에 대응해야 하는 실환경에서의 로봇 인식 기술의 안정성을 높이는 데 기여할 것으로 기대한다”고 설명했다. 이번 논문은 로봇공학·자율주행·지능형 시스템 분야를 대표하는 국제학술대회 ‘IROS 2026’(IEEE/RSJ International Conference on Intelligent Robots and Systems)에 ‘DAWN: Noise-Robust Quadruped Parkour via Depth-Denoising World Models’라는 제목으로 채택됐다. 논문은 2026년 9월 27일부터 10월 1일까지 미국 펜실베이니아주 피츠버그에서 발표될 예정이다.
  • 하늘 사진 본 AI “붉은빛 어우러져”… LG ‘캡셔닝 인공지능’ 육성

    인공지능이 이미지 이해·설명의학 분야 등 다양한 활용 기대 LG가 이미지를 이해하고 설명하는 인공지능(AI)을 키우는 데 속도를 낸다. 글로벌 AI 연구자들을 대상으로 AI의 이미지 이해 능력을 평가하는 대회를 세계에서 처음으로 열며 인간의 시각 인지 능력에 한발 더 가까워진 초거대 멀티모달 AI 기술 생태계를 넓힌다. LG는 2월 1일부터 오는 4월 말까지 제로샷 이미지 캡셔닝을 주제로 한 ‘LG 글로벌 AI 챌린지’를 온라인으로 개최한다고 31일 밝혔다. 제로샷 이미지 캡셔닝은 AI가 사람처럼 처음 본 사물이나 동물, 풍경 등이 포함된 이미지를 봤을 때 학습한 데이터를 기반 삼아 스스로 이해하고 판단한 결과를 텍스트로 설명하는 기술이다. 이 기술이 고도화되면 사람들의 일상에 실질적인 도움이 되는 기술 개발을 앞당길 수 있다. 온라인상에 매일 올라오는 방대한 분량의 이미지 데이터를 AI가 자동으로 캡션과 키워드를 만들어 검색의 정확도, 편의성을 높여 줄 수 있다. 의학 전문 데이터를 학습해 의학 영상을 분석하는 ‘의학 전문가 AI’로도 활용할 수 있다. LG AI연구원은 공동연구센터를 세워 초거대 멀티모달 AI인 ‘엑사원’(EXAONE)을 연구 중인 서울대 AI대학원, 이미지 캡셔닝 AI의 상용화 서비스를 함께 추진하는 셔터스톡과 함께 대회를 진행한다. 이경무 서울대 AI대학원 석좌교수는 “해당 기술은 AI가 인간의 지능에 얼마나 가까워졌는지 보여 주는 하나의 척도”라며 “학습 데이터 없이도 이러한 작업을 수행하는 제로샷 이미지 캡셔닝은 매우 도전적인 문제이자 세계적으로도 최근에 연구가 시작된 분야로, 우리나라의 AI 역량이 이미 세계적인 수준에 도달했음을 의미한다”고 평가했다.
  • AI가 처음 본 이미지 이해하고 설명...초거대 AI 키우는 LG

    AI가 처음 본 이미지 이해하고 설명...초거대 AI 키우는 LG

    LG가 이미지를 이해하고 설명하는 인공지능(AI)을 키우는 데 속도를 낸다. 글로벌 AI 연구자들을 대상으로 AI의 이미지 이해 능력을 평가하는 대회를 세계에서 처음 열며 인간의 시각 인지 능력에 한 발 더 가까워진 초거대 멀티모달 AI 기술 생태계를 넓힌다.LG는 2월 1일부터 4월 말까지 제로샷 이미지 캡셔닝을 주제로 한 ‘LG 글로벌 AI 챌린지’를 온라인으로 개최한다고 31일 밝혔다. 제로샷 이미지 캡셔닝은 AI가 사람처럼 처음 본 사물이나 동물, 풍경 등이 포함된 이미지를 봤을 때 학습한 데이터를 기반삼아 스스로 이해하고 판단한 결과를 텍스트로 설명하는 기술이다. 이 기술이 고도화되면 사람들의 일상에 실질적인 도움이 되는 기술 개발을 앞당길 수 있다. 온라인상에 매일 올라오는 방대한 분량의 이미지 데이터를 AI가 자동으로 캡션과 키워드를 만들어 검색의 정확도, 편의성을 높여줄 수 있다. 의학 전문 데이터를 학습해 의학 영상을 분석하는 ‘의학 전문가 AI’로도 활용할 수 있다.LG AI연구원은 공동연구센터를 세워 초거대 멀티모달 AI인 ‘엑사원(EXAONE)’을 연구 중인 서울대학교 AI대학원, 이미지 캡셔닝 AI의 상용화 서비스를 함께 추진하는 셔터스톡과 함께 대회를 진행한다. 이경무 서울대 AI대학원 석좌교수는 “해당 기술은 AI가 인간의 지능에 얼마나 가까워졌는지 보여주는 하나의 척도”라며 “학습 데이터 없이도 이러한 작업을 수행하는 제로샷 이미지 캡셔닝은 매우 도전적인 문제이자 세계적으로도 최근에 연구가 시작된 분야로 우리나라의 AI 역량이 이미 세계적인 수준에 도달했음을 의미한다”고 평가했다.
위로